0:00 0:00
記事
Google DeepMind「AlphaGenome 2」発表——1億超の細胞データで学習、病気に関わる変異の検出数が約2倍に
Google DeepMindがDNA配列モデルの次世代版AlphaGenome 2を発表しました。組織単位から細胞の種類・状態単位へと予測の粒度を細かくし、遺伝子発現を変える変異の検出数は従来比で約2倍になりました。非商用研究向けにはAlphaGenome API経由で本日から利用できます。
Google DeepMindは2026年11月11日、DNA配列から遺伝子の働きを予測するモデルの次世代版「AlphaGenome 2」を発表しました。DNAのわずかな違い(変異)が、心筋細胞や免疫細胞といった個々の細胞の中でどのような影響を及ぼすのかを予測できるモデルです。
AlphaGenome 2は、遺伝子発現を変化させる変異を従来モデルの約2倍見つけられるようになりました。68の組織にまたがる1億件以上の細胞プロファイルで学習しており、非商用研究向けにはAlphaGenome APIを通じて本日から利用できます。商用研究向けにはプライベートプレビューとして提供されます。
組織の平均から「細胞ごと」の予測へ
人間の体の細胞は、どれも同じDNAを持っています。それでも心臓の筋肉と、感染と戦う免疫細胞とでは、オンになる遺伝子が大きく異なります。Human Cell Atlasのような国際プロジェクトは数百万個の細胞について遺伝子発現の地図を作ってきましたが、DNAの細かな違いが細胞ごとの発現をどう変えるのかを予測することは、まだ解けていない課題でした。
DeepMindは2025年に初代AlphaGenomeを公開し、続いてヒトゲノム上で起こりうる約90億通りの1塩基変異すべてについて予測値を収めた「AlphaGenome Atlas」も提供してきました。ただし、これらは組織全体を平均した単位での予測です。AlphaGenome 2は粒度を個々の細胞の種類や状態まで細かくし、組織単位のモデルでは埋もれてしまう病気に関連した細胞での影響も捉えられるようになりました。
「条件付きモデル」へと設計を刷新
初代AlphaGenomeは、100万塩基のDNA配列を受け取り、多数の組織や実験の結果をまとめて並列に出力する設計でした。効率は良い一方で、モデルの表現力が多くの出力に分散してしまい、よく似た細胞の種類どうしの細かな差を捉えにくいという弱点がありました。
AlphaGenome 2では、この部分を根本から作り直しています。DNA配列に加えて「どの組織・細胞の種類・状態について予測するか」という条件を入力として受け取り、一度に1つの条件について予測する「条件付きモデル」になりました。条件はアーキテクチャの各段階で参照されるため、同じDNAの領域が細胞の種類によってどう読み分けられるのかを学習できます。
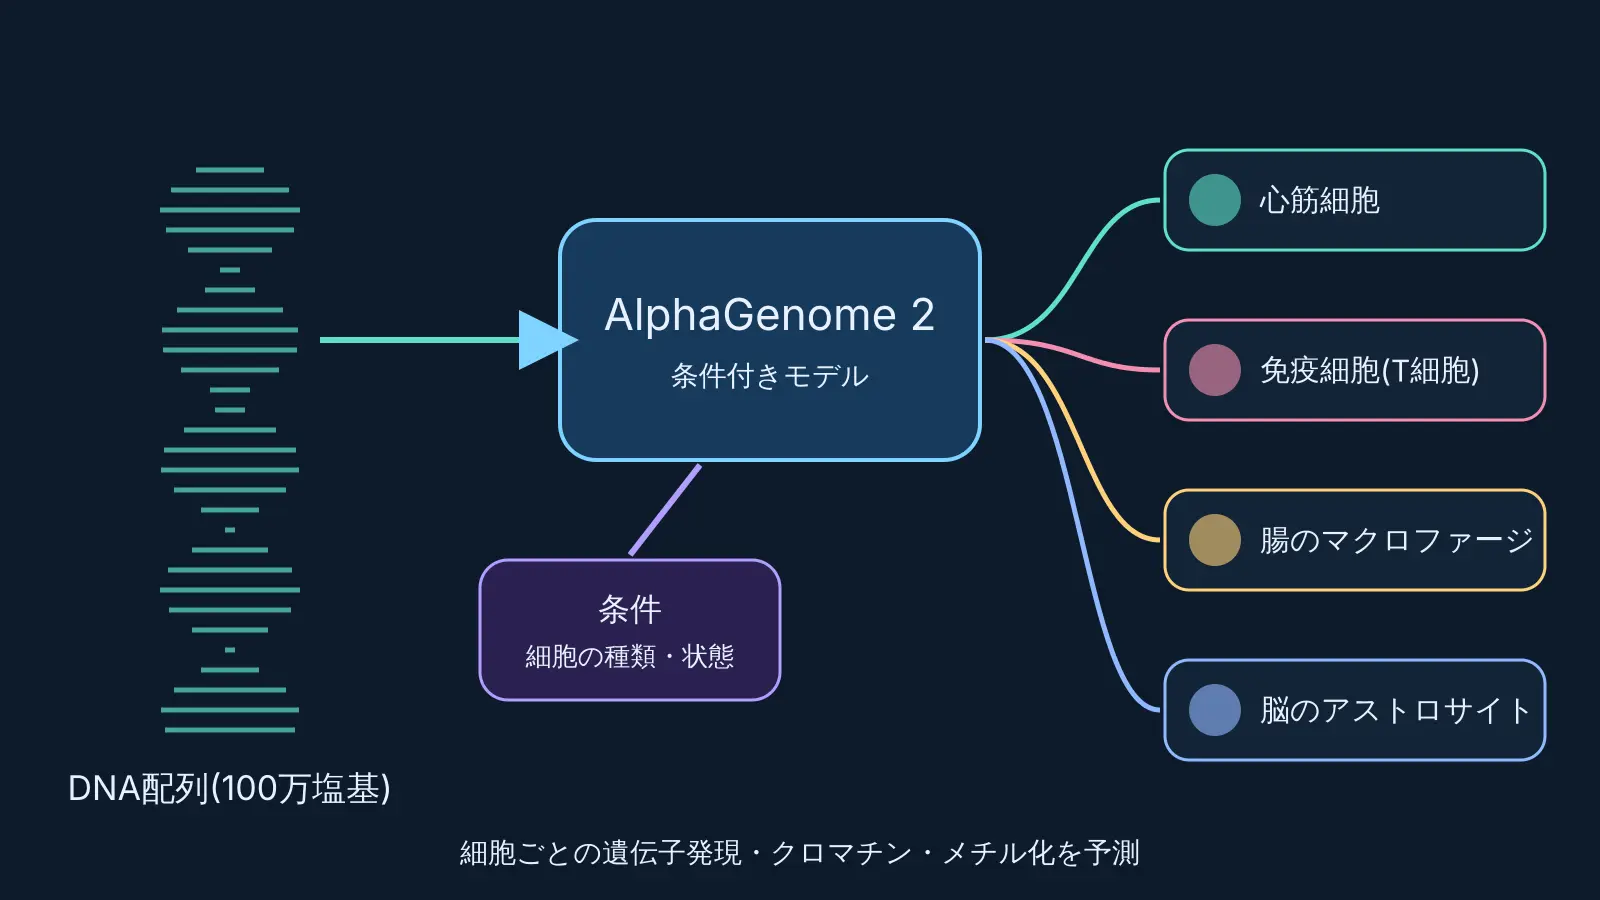 図: Google DeepMindの発表内容をもとに編集部で作成
予測の対象は、遺伝子発現、ヒストン修飾、クロマチンのアクセシビリティなど初代と同じ項目に加え、要望の多かったDNAメチル化も含まれるようになりました。学習にはヒトとマウスのバルクデータと単一細胞データが使われ、個別の細胞プロファイルは1億700万件を超えます。
ベンチマークで検出数がほぼ倍増
DeepMindが公開した主な評価結果は次のとおりです。
| 評価の観点 | AlphaGenome 2の結果 |
|---|---|
| 細胞の種類ごとの差 | 学習に使っていないゲノム領域でも、組織内の細胞間で異なる遺伝子発現をより多く説明できた |
| 原因変異の特定(TenK10K) | 原因となる変異の検出率が30%(比較対象は16%) |
| 遺伝子への影響の向き | 発現を上げるか下げるかの判定が43%(比較対象は23%) |
| 既知の疾患研究の再現 | 炎症性腸疾患でETS2遺伝子を過剰に働かせる変異を特定 |
TenK10Kは28種類の免疫細胞を対象とした大規模な単一細胞データセットで、比較対象は単一細胞データでファインチューニングした初代AlphaGenomeなどの専門ツールです。炎症性腸疾患の例では、腸のマクロファージでだけETS2遺伝子が強く働き、ほかの細胞や遺伝子にはほとんど影響しないことを計算だけで再現しました。
再学習なしで新しい細胞状態にも対応
AlphaGenome 2のもう1つの特徴は、新しい単一細胞実験のデータに再学習なしで対応できる点です。研究者が数十個程度の細胞から得た単一細胞RNA-seqのデータをアップロードすると、その遺伝子活性が細胞状態の表現に圧縮され、モデルの条件として使われます。DeepMindによると、そのデータセットで直接学習またはファインチューニングしたモデルと同等以上の精度が出るといいます。
例として、新型コロナウイルスのmRNAワクチンを扱った未学習のデータでは、ワクチンで活性化したT細胞と休止状態のT細胞を区別できました。さらに、重症化に関連する変異が、活性化した状態の細胞でより強く遺伝子の働きを乱すことも示しています。休止状態の細胞だけを見ていると見落としてしまう効果です。
GWASの結果を細胞レベルにつなぐ
病気の理解には、ヒトの遺伝学と細胞生物学を結びつけることが欠かせません。ゲノムワイド関連解析(GWAS)は病気と関係するDNAの領域を広く示してくれますが、そこから原因となる変異、標的の遺伝子、影響が出る細胞の種類までを確信を持って絞り込むのは難しい作業です。
そこでDeepMindは、形質や疾患に関連する変異について、数百種類のヒトの細胞・組織条件でAlphaGenome 2の予測値をあらかじめ計算して公開しました。研究者は大規模な計算を自分で回さなくても、身長から2型糖尿病までさまざまな形質について、関与しそうな変異と細胞の種類を絞り込めます。脳のアストロサイトのように培養細胞株では調べにくい細胞についても、遠く離れた調節領域(エンハンサー)と遺伝子のつながりを推定できるようになりました。
創薬やゲノム研究の現場への影響
Human Cell Atlasの共同創設者であるケンブリッジ大学のSarah Teichmann教授は、少数の細胞からでも新しい細胞状態での変異の働きを予測できる点を評価しています。Genomics LimitedのCEOであるPeter Donnelly氏も、GWASの関連シグナルから創薬プログラムに必要な情報へと橋渡しする手段として期待を示し、同社のプラットフォームに組み込む予定だと述べています。
ゲノム解析や創薬に関わる研究者にとっては、手元の単一細胞データを条件として渡すだけで変異の影響を細胞単位で見積もれる点が大きいはずです。次にどの実験を優先すべきかを決める材料にもなります。まずは非商用ライセンスのAPIで、自分たちが追っている変異や細胞の種類で予測がどこまで実験結果と合うのかを確かめてみるとよいでしょう。
Google DeepMind Blog
AlphaGenome 2: Deciphering how cells read DNA to better understand disease



