0:00 0:00
記事
Block、人間そっくりに話す新音声AI「Dessa」を発表——笑いや間まで再現するフルデュプレックスモデル
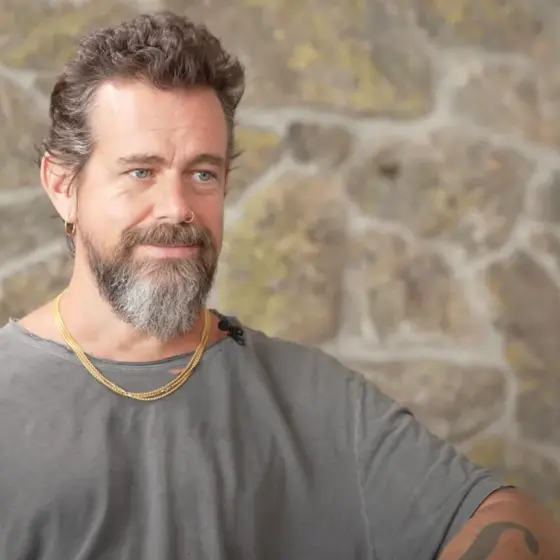
Jack Dorsey率いるBlockの研究部門が、感情や間まで人間らしく再現する新しい音声AIモデル「Dessa」を発表しました。テキストを介さず音声のみで学習したフルデュプレックスモデルで、ローカル実行が可能といいます。TechCrunchが報じています。
決済サービスなどを手がけるBlockの研究部門が、新しい音声AIモデル「Dessa」を発表しました。笑い声や間、涙声といった人間らしい表現をそのまま再現できるのが特徴で、1枚のNVIDIA製GPUラックと人間の音声データのみで学習したといいます。Block共同創業者のJack Dorsey氏自身もSNSで「人と話しているように感じる」と投稿しており、既存の音声AIとは一線を画す完成度を打ち出しています。TechCrunchが報じています。
テキストを介さないフルデュプレックス設計
Dessaは「フルデュプレックス」モデルで、話すことと聞くことを同時にこなせる点が大きな特徴です。これは今年前半にOpenAIが公開した「GPT-Live」モデルと同様の仕組みで、一般的な音声AIのように大規模言語モデルと組み合わせて知識を補う構成ではありません。Blockによれば、Dessaの知識は会話データそのものに由来しており、音声から音声への変換だけで応答を生成しているとのことです。テキストを一度経由してから音声化する従来型のパイプラインとは根本的に異なるアプローチを採っています。
感情表現を「タグ」ではなく音声だけで学習
ElevenLabs v4やFish Audio Drama 3のような既存の音声生成モデルの多くは、感情を表現するために「タグ」と呼ばれる制御情報をテキストに埋め込む手法を使っています。Blockはこの点を名指しで指摘し、Dessaでは感情そのものがモデルに組み込まれていると主張しています。公式ブログでは「現在の音声AIとのやり取りは、はっきり言って残念なことが多い。声をテキストに変換する過程で、テキストだけでは伝わらない膨大な情報が失われてしまう」と説明しており、テキスト経由の処理そのものが表現力を損なう原因だとしています。研究チームが公開した会話例では、仕事疲れを話すシーンで実際に疲れたような声色になるなど、文脈に応じた自然な抑揚が確認できるといいます。
ローカル実行が可能、公開はまだ先
Dessaのもう一つの特徴は、MacBook M4 Max程度の一般的なコンシューマー向けマシンでもローカル実行できるとされている点です。クラウド経由ではなく端末上で動作する音声AIが実用段階に近づいていることを示す事例といえます。ただし現時点で一般向けの公開や試用の手段は用意されておらず、Blockは悪用リスクを検証するための安全性研究者の募集を始めている段階です。人間と見分けがつきにくい音声は、なりすましや詐欺への悪用が懸念されるため、公開前の慎重な検証を優先する姿勢とみられます。
決済事業との接点、将来の応用に注目
Blockは本来、中小企業向けの決済・金融サービスを主力事業とする企業です。傘下のSquareはすでに音声AIを使った注文受付を一部で導入しており、今回自社開発の音声モデルを持つことで、こうした体験をより低コストで、かつ端末上で完結する形で拡張できる可能性があります。決済という実務的な領域に、人間らしい自然さを備えた音声AIがどう組み込まれていくのか、今後の展開が注目されます。読者としても、電話注文や音声アシスタント越しの問い合わせが、近いうちに人間との会話と区別しにくくなる未来を意識しておいて損はなさそうです。

Block's new voice model sounds eerily human
Typically, speech models are paired with a large language model for knowledge retrieval. Block said that Dessa's knowledge stems from the conversational data it has.



