0:00 0:00
記事
Dharma-AI、文書画像から指定項目をJSONで抜き出す2Bモデル「Field Extractor」を公開——最先端LLMより高精度で最大147分の1のコストとうたう
Dharma-AIが、請求書や身分証などの文書画像から必要な項目だけを型付きのJSONで返す20億パラメータのモデル「Dharma Field Extractor」をHugging Face Blogで公開しました。自社ベンチマークでは、Claude Opus 5やGPT-5.6を上回る0.834のスコアを記録したとしています。
AI企業のDharma-AIは、Hugging Faceの公式ブログで、文書の画像から必要な項目だけを取り出し、構造化されたJSONとして返すモデル「Dharma Field Extractor」を公開しました。パラメータ数は20億と小さく、同社のベンチマークでは試したすべての最先端LLMを上回る精度を、はるかに低いコストで出せたとしています。
OCRと「項目抽出」は別の仕事
Dharma-AIは4月に、契約書や裁判書類、請求書、身分証、各種フォームなどのOCRに特化した「DharmaOCR-LITE」を公開していました。OCRはページ上の文字を元の書式どおりに書き出すため、契約書を最後まで読む、原稿をデジタル化するといった用途に向いています。
一方で、業務システムに取り込みたいのはページ全体ではなく、特定の項目であることが多いと同社は説明します。請求書の明細を一覧で、医療機関の検査依頼書から患者名、検査の種類、日付を、身分証から社員台帳の列に合わせた項目を、という具合です。OCRの結果からどの文字列が日付でどれが合計金額かを割り当てるには、結局誰かが変換コードを書く必要があります。汎用LLMに頼むこともできますが、大量の文書を処理する業務では、APIの料金と待ち時間が重くのしかかります。
スキーマなしでも、スキーマ指定でも使える
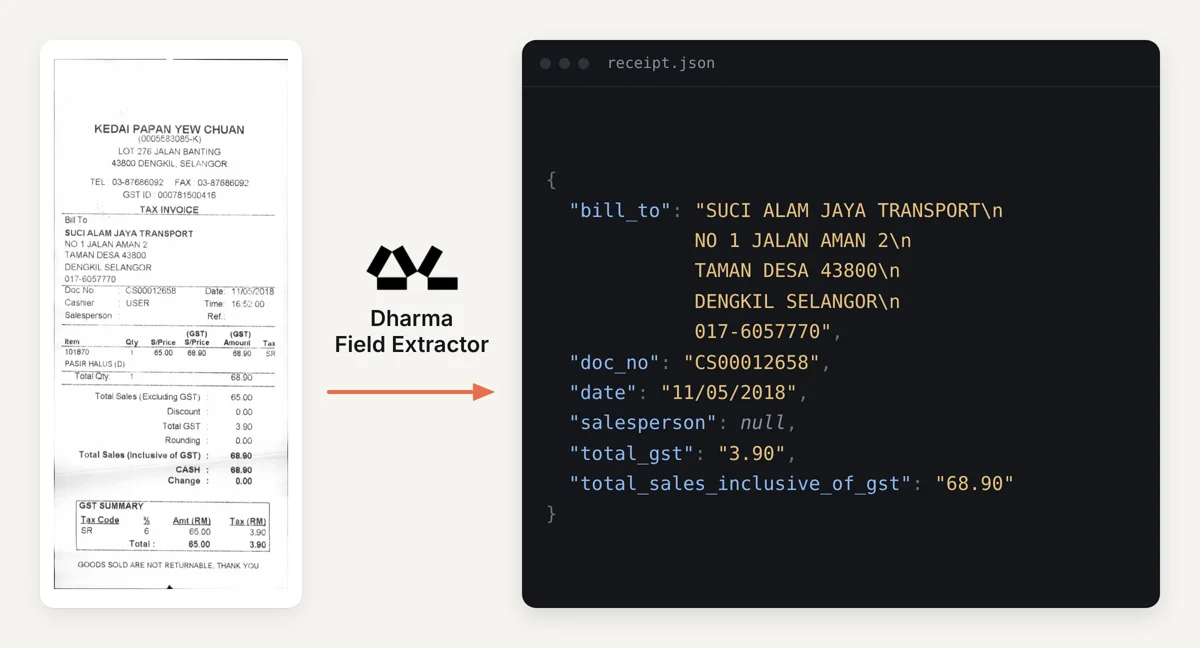
Field Extractorは文書画像を受け取り、2つの方法で項目を返します。
| モード | 動き | 向いている場面 |
|---|---|---|
| オープン | スキーマを渡さず、ラベルと値の組や表の構造を文脈とレイアウトから見つけて、すべてキーと値で返す | 文書に何が書かれているか分からないとき |
| スキーマ指定 | 欲しい項目と型(文字列・数値・真偽値)を、自社システムのキー名で指定する | 出力を既存のデータ形式に合わせたいとき |
スキーマ指定では、指定したキー名がそのまま返り、余計な項目は付きません。表を指定すれば行と列ごとに埋め、文書にない項目を求めた場合は値をでっち上げずにnullを返すとしています。ベースは、OCR向けに教師ありファインチューニングとDPOを施した20億パラメータの「DharmaOCR-LITE v1.1」で、その上に4万3384件の学習例でLoRAアダプターを学習させました。学習データは英語の多分野の文書、社内で集めたポルトガル語のブラジルの実文書、その他の欧州・アジア言語の3系統です。
画像引用元: Hugging Face Blog
自社ベンチマークでClaude Opus 5を上回るスコア
評価には546文書を使い、「スキーマなしで全項目を抽出」「実在する項目だけのスキーマ」「存在しない項目をわざと含めたスキーマ」の3つの条件を合わせて1638ケースを用意しました。スコアは項目単位のF1に、値の文字列の一致度と、有効なJSONで返った割合を掛け合わせたものです。
その結果、Field Extractorは0.834を記録し、最も近かったClaude Opus 5の0.816、最も差が開いたGPT-5.6 Lunaの0.741を上回ったと発表しています。学習に使っていない公開データセットのSROIEのレシートでは18項目すべてを正しく取り出し、FUNSDのチェックリスト形式のフォームでも、チェックの入った1項目だけをtrueと判定できたと紹介しています。
コストは最大147分の1、ただし比較条件に注意
コスト面では、GPT-5.6 Lunaの約6分の1から、GPT-5.6 Solの約147分の1まで安くなったとしています。ただし計算方法は両者で異なり、最先端モデルは1ページあたりの入出力トークンと推論トークンを各社の公表価格で換算したのに対し、Field Extractorは1時間2.24ドルのL40S GPU1枚で動かした時間から算出しています。Dharma-AI自身も、これは販売価格ではなく、ハードウェアや処理量、求める応答速度によって変わると断っています。
ベンチマークは同社が設計したもので、最先端モデルは推論の設定を「low」にして比べています。数字をそのまま一般化するより、「範囲の決まったタスクなら、専用に学習した小型モデルが汎用の最先端モデルに勝てる」という同社の主張を裏付ける一例として受け止めるのが妥当でしょう。
日本語の帳票で使うなら自社データでの検証が前提
学習データの中心は英語とブラジルのポルトガル語の文書で、その他の欧州・アジア言語は小さな割合にとどまります。縦書きや手書きの多い日本語の請求書、印鑑の押された申込書などでどこまで精度が出るかは、今回の発表からは分かりません。
社内の請求書処理や申込書の入力作業をLLMで自動化しようとしている企業は、まず自社の文書を数十件ほど用意し、汎用LLMのAPIと小型の専用モデルの精度とコストを並べて比べてみる価値がありそうです。自社サーバーで動かせる小型モデルなら、個人情報を含む書類を外部のAPIに送らずに済むという利点もあります。Hugging Face上のデモで、手元の文書を試すこともできます。

Dharma Field Extractor: Any Document In, Structured Fields in JSON Out
A Blog post by Dharma-AI on Hugging Face



