0:00 0:00
記事
FLUX 3 Image KleinをNVIDIA B200で最大4.45倍高速化——TensorRT LLM VisualGenの5つの最適化
NVIDIAが、Black Forest Labsの画像生成・編集モデルFLUX 3 Image KleinをTensorRT LLM VisualGenで高速化する手順を公開しました。NVFP4量子化、融合GEMMカーネル、量子化・スパースアテンション、ステップキャッシュ、マルチGPU並列を組み合わせ、B200 1基で画像編集を最大4.45倍速くしています。
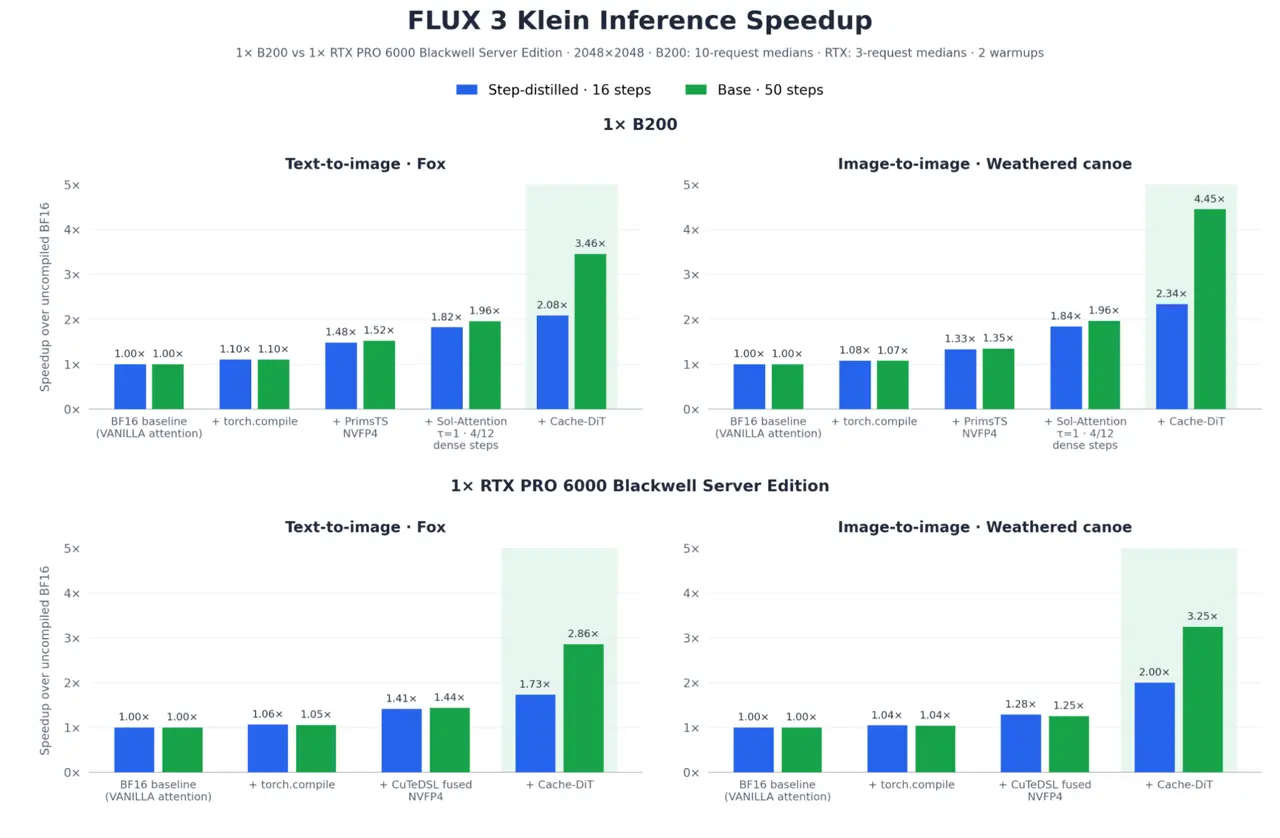
NVIDIAは2026年11月6日、Black Forest Labs(BFL)の画像生成・編集モデル「FLUX 3 Image Klein」を、TensorRT LLMの画像・動画向けランタイム「VisualGen」で高速化する方法を技術ブログで解説しました。2048×2048の画像をNVIDIA Blackwell世代のB200 1基で生成した場合、最適化を重ねることで、コンパイルなしのBF16推論に比べてテキストからの画像生成(T2I)が最大3.46倍、画像編集(I2I)が最大4.45倍速くなりました。
FLUX 3 Image Kleinの構成
FLUX 3 Image Kleinは、BFLがNVIDIA GB200 NVL72で学習した画像の生成・編集モデルです。品質を重視した「Base」と、少ないステップで生成できる蒸留版の2種類のチェックポイントが用意されています。
モデルは3つの部品で構成されます。テキストの条件付けにはQwen3-VLの4Bモデルを使い、拡散Transformer(DiT)が画像の潜在表現を繰り返し整え、オートエンコーダーが潜在表現を画像に戻します。テキスト、ノイズを含む生成対象の画像、参照画像の3つの流れを別々に処理したあと、ジョイントアテンションでまとめる設計です。生成時間の大半はDiTのノイズ除去が占めるため、NVIDIAの最適化もこの部分に集中しています。
画像引用元: NVIDIA Technical Blog
5つの最適化と効果
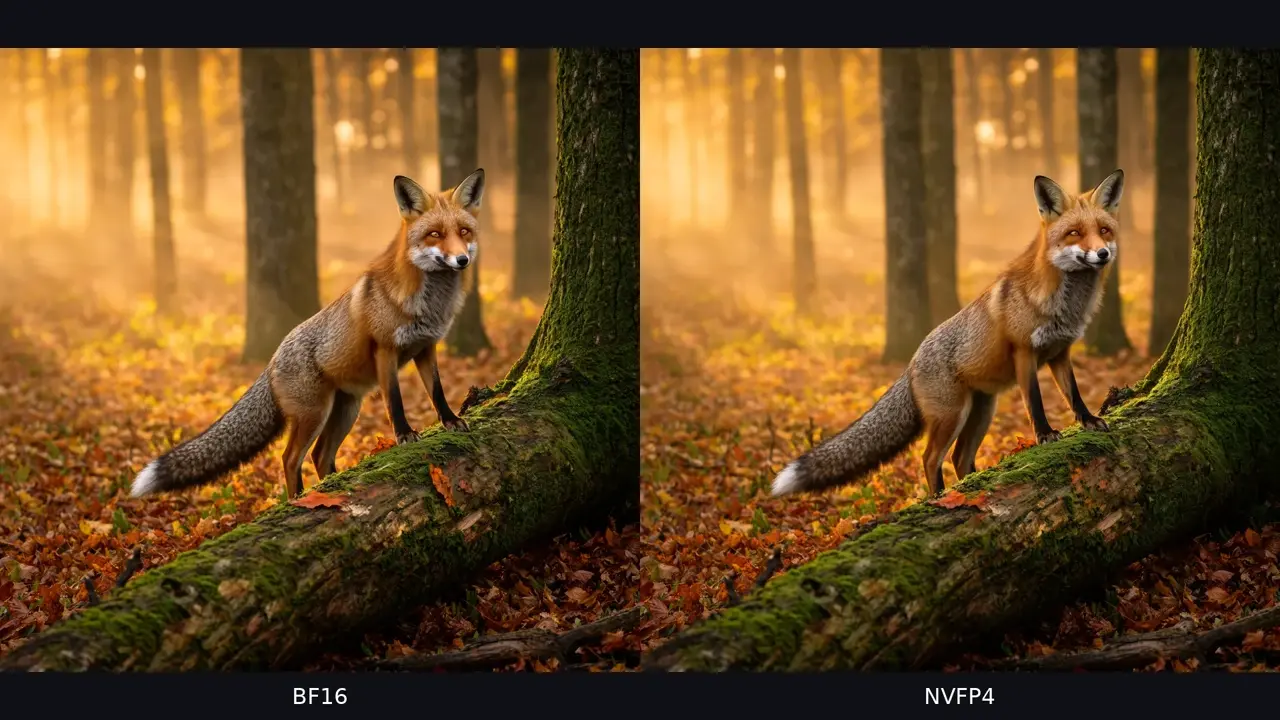
VisualGenでは、BFLが配布するNVFP4量子化済みのチェックポイントをそのまま読み込めます。NVFP4にするだけで、BF16と比べてT2Iが最大1.62倍、I2Iが最大1.58倍速くなりました。NVIDIAはここを出発点に、次の最適化を重ねています。
| 最適化 | 内容 | 主な効果(B200、2048×2048) |
|---|---|---|
| PrimsTS GEMM | FlashInferの融合カーネル | T2Iで1.02〜1.10倍 |
| 量子化アテンション | cuDNN FP8またはVC-Attention FP8 | VC-Attentionで1.18倍 |
| スパースアテンション | Sol-Attention(τ=1.0) | ノイズ除去とデコードで1.24〜1.30倍 |
| ステップキャッシュ | Cache-DiT(しきい値0.24) | Baseで1.94倍 |
| マルチGPU | CFG並列とUlysses並列(8基) | Baseで14.90秒から3.00秒へ |
PrimsTSはCUTLASSをもとにしたFP8/NVFP4の行列演算カーネルで、SwiGLUやQKV射影、RoPEなどの後処理を1つにまとめています。FLUX 3のテンソル形状に合わせて調整されており、初期設定で有効になります。
アテンションとキャッシュの選び方
高解像度の画像生成では、アテンションが大きなボトルネックになります。NVIDIAの計測では、2048×2048のT2Iで、BF16のアテンションがDiTのGPUカーネル時間の約60%を占めていました。
量子化アテンションでは、cuDNN FP8がBaseで1.08倍、VC-Attention FP8が1.18倍の高速化でした。画質の差を示すLPIPS(低いほど元の出力に近い)は、Baseでそれぞれ0.072と0.086です。NVIDIAはB200での2048×2048生成ではVC-Attention FP8を推奨しています。Sol-Attentionは最初の何ステップを通常のアテンションで処理するかで画質と速度が変わり、16ステップなら画質重視、12ステップなら速度重視という目安が示されました。
Cache-DiTは、ノイズ除去のステップ間でTransformerの中間出力を使い回す手法です。再学習やモデルの重みの変更は要りません。Baseでは1024×1024で1.97倍、2048×2048で1.94倍とほぼ半分の時間になり、LPIPSは0.033〜0.038に収まりました。蒸留版はもともとのステップ数が16と少ないため、効果は1.2倍前後にとどまります。
画像引用元: NVIDIA Technical Blog
8基構成とRTX PRO 6000での結果
DGX B200でGPUを1基から8基に増やすと、2048×2048のT2Iの所要時間の中央値は、Baseで14.90秒から3.00秒、蒸留版で2.73秒から1.08秒に短縮されました。ノイズ除去だけを見るとBaseで6.01倍、蒸留版で4.44倍の高速化です。ただし蒸留版は8基構成で処理時間のおよそ半分がノイズ除去以外の部分になり、全体の伸びはそこで頭打ちになります。
すべての最適化を重ねた単一B200の結果は、T2Iが22.36秒から6.46秒、I2Iが54.64秒から12.28秒でした。サーバー向けのRTX PRO 6000 Blackwell Server Editionでも、コンパイル、NVFP4、Cache-DiTの組み合わせで1.73〜3.25倍の高速化が得られています。
画像生成サービスを運用する開発者への影響
今回の解説は、各最適化をYAMLの設定で切り替えられる形で提供されている点が実用的です。チェックポイントの種類、アテンションの方式、キャッシュのしきい値、並列数をそれぞれ設定ファイルで指定でき、TensorRT LLMのリポジトリにはFLUX 3向けのサンプルも用意されています。
画像編集ツールやクリエイティブ系のサービスでFLUX系モデルを動かしている場合は、まずNVFP4のチェックポイントとCache-DiTを試すと効果がわかりやすいでしょう。品質への影響はLPIPSで数値化されているので、自社のプロンプトで同じ指標を測り、許容できる範囲でSol-Attentionや量子化アテンションを足していく進め方が現実的です。

Speed Up Image Generation with FLUX 3 Image Klein on NVIDIA Blackwell GPUs
When deploying diffusion models in design tools, image editors, and visual production workflows, developers must account for inference latency. Generating an image requires multiple sequential passes…



