0:00 0:00
記事
Gemini 4 Hydrogen登場、速さ重視の新モデルが上位のArgonを指標で上回る——入力100万トークン1.5ドルで全ユーザーに提供
Google DeepMindが「Gemini 4 Hydrogen」を発表しました。日常的なコーディングやエージェント処理向けの高速モデルで、Artificial Analysis Intelligence IndexでGemini 4 Argonを上回ります。Gemini API、Geminiアプリ、Google検索などで同日から順次提供されます。
Google DeepMindは2026年11月12日、新しいAIモデル「Gemini 4 Hydrogen」を発表しました。日常的なコーディングやエージェント型の処理を、速く効率よくこなすことを狙ったモデルです。同日からGoogle AI StudioとGemini APIの全ティア、Geminiアプリ、Google検索などで順次使えるようになります。
Gemini 4ファミリーには、すでに長時間の深い推論を得意とする「Gemini 4 Carbon」と「Gemini 4 Argon」があります。Hydrogenはこれらと役割を分け、多様なエージェント処理を素早く実行する担当として位置付けられています。Gemini 4を一般のユーザーまで広く届けるモデルでもあります。
Argonを上回る指標と、フラットな料金体系
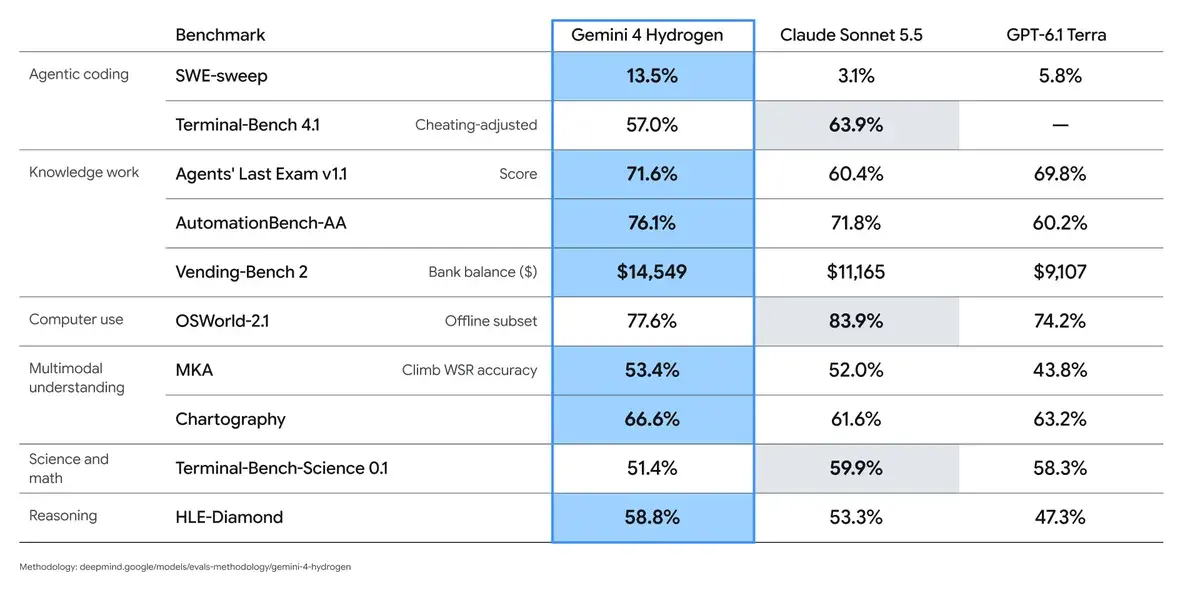
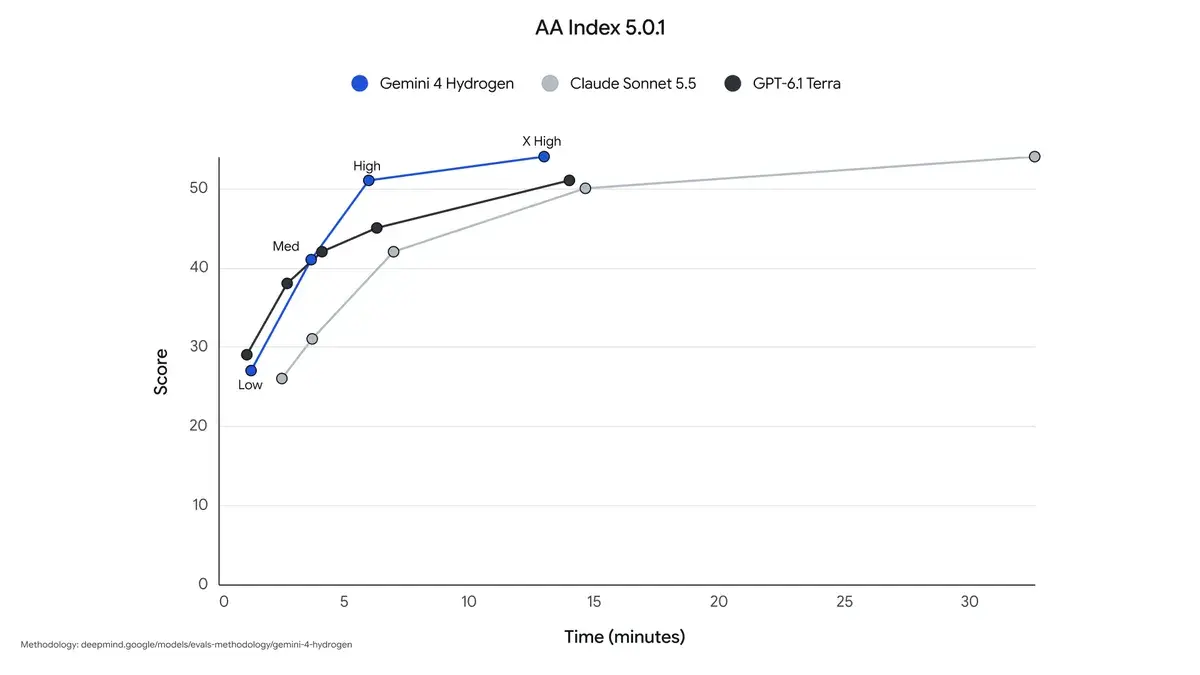
Hydrogenは、Artificial AnalysisのIntelligence Indexで、標準の思考レベル(high)で51を記録しました。上位モデルのArgon(50)をわずかに上回り、最も深い思考レベル(xhigh)では54に達します。それでいて、同クラスのモデルより速くタスクを終えることが多いとしています。
料金は100万トークンのコンテキストウィンドウ全体で一律です。入力が100万トークンあたり1.50ドル、出力が7.50ドルで、長い入力を渡しても単価は上がりません。コンテキストの長さによって単価が変わる料金体系に比べると、コストの見積もりがしやすくなります。
 画像引用元: Google DeepMind Blog
Gemini 3.8 Flashからの乗り換えで何が変わるか
Googleは、前世代の「Gemini 3.8 Flash」から移行するチームにとって大きな更新になるとしています。主な改善点は次のとおりです。
| 項目 | Gemini 3.8 Flashとの比較 |
|---|---|
| タスク完了までの速さ | 標準設定で2.5倍速い |
| Terminal-Bench 4.1 | 18.2%から57%へ、3倍超 |
| 事実と異なる主張 | 5分の1以下に減少 |
| パートナーの実務検証 | 2〜2.8倍高速、トークン使用量は12〜23%削減 |
ツール呼び出しが失敗したときや、検索結果が空だったときにも、きちんと方針を切り替えられるようになったといいます。大きなリポジトリを調べる場面では、ファイルの読み込みや検索をひとつずつではなく並列でまとめて実行するのが得意だとしています。
Antigravityの「Orchestrator」でモデルを自動で使い分け
実際のソフトウェア開発では、システム設計や込み入ったバグの調査にはCarbonやArgonのような上位モデルが向いています。一方で、コードを書き、テストを走らせ、変更を確かめる作業には、速くて手堅い実行役が欠かせません。Hydrogenは単体でも使えますが、上位モデルと組み合わせる実行役も想定しています。
この組み合わせを自動化するため、Googleの開発環境「Google Antigravity」に「Orchestrator」が加わりました。1つのセッションの中で、CarbonとHydrogenを状況に応じて切り替える機能です。Terminal-Bench 4.0では、Carbonに近いタスク成功率を保ったまま、利用枠の消費を平均24%抑え、完了までの時間を19%短縮しました。並列エージェントの構成では、Carbonが全体を調整し、Hydrogenが作業役や検証役として隔離された環境で同時に動く使い方も紹介されています。
4段階の思考レベルで速度とコストを調整
Hydrogenには、low、medium、high(標準)、そして新設のxhighという4つの思考レベルがあります。品質、待ち時間、コストのバランスをなめらかに変えられるため、タスクに必要な分だけ考えさせ、その分だけ支払えばよい設計です。
どの思考レベルでも、同クラスの競合モデルと同等以上の性能を出しつつ、出力トークン数は少なめに収まることが多いとしています。ちょっとした修正ならlowで素早く、難しい調査ならxhighで粘らせるといった使い分けがしやすくなります。
 画像引用元: Google DeepMind Blog
Geminiアプリと検索での変化
一般ユーザー向けには、Geminiアプリと検索が強化されます。Geminiアプリでは、指示により忠実に従い、適切なツールを呼び出して、やり取りの往復を減らすとしています。メールの下書きや資料の書き直しは、指定したトーンや形式を守ったまま一度で使える状態になりやすくなります。GmailやGoogleドライブ、AirtableやDropboxといった連携アプリからも必要な情報を集めて、タスクを順番に片付けます。
検索では、全世界のすべてのユーザーに向けて回答が改善されます。複数の要素を含む質問や、誤字の多い質問でも意図をくみ取りやすくなり、表示はより視覚的で読み取りやすくなります。さらに、質問を分解して複数の検索を並行させる「クエリファンアウト」も強化され、これまで見つけにくかったサイトへのリンクが増えるとしています。
安全性と提供範囲
安全面では、Gemini 3.8 Flashと比べ、エージェント処理での行き過ぎた動作を最大81%、逆に必要な作業をしない「やらなさすぎ」を最大79%減らしました。ツール利用やコーディングの評価では、意図に反した行動や手抜きを12分の1に抑えています。間接的なプロンプトインジェクションへの耐性も、Gray Swan IPIベンチマークで2.3倍以上に高まりました。
提供範囲は広く、開発者はGemini APIとAI Studio、Android Studioの有料ティアで利用できます。Google AI ProとUltraの契約者はGoogle Antigravityでも試せます。企業向けにはGemini for businessやGemini in Google Sheetsで提供され、Geminiアプリでは無料ユーザーも自動のモデル選択を通じて使えます。
「安くて速い実行役」をどう組み込むか
今回の発表で注目したいのは、上位モデルに近い賢さを持つ実行役が、入力100万トークン1.50ドルで手に入る点です。上位モデルで設計し、Hydrogenで実装とテストを回すという分担は、エージェントを使った開発のコストを大きく下げる可能性があります。
Gemini 3.8 Flashを使ったワークフローを運用しているチームは、まずHydrogenへの置き換えで速度と精度がどう変わるかを測ってみるとよいでしょう。思考レベルを変えたときのコスト差も、あわせて確認しておくと移行の判断がしやすくなります。

Introducing Gemini 4 Hydrogen
Today, we’re introducing Gemini 4 Hydrogen, our daily driver for agentic workflows



