0:00 0:00
記事
Google、第8世代TPUに「8tx」と「8i Max」を追加——1年で4システム、機密推論と巨大コンテキストに特化
Googleは第8世代TPUのラインアップにTPU 8txとTPU 8i Maxを追加しました。8txはハードウェアレベルの機密コンピューティングに、8i Maxは2チップを1パッケージに収めて巨大なコンテキストウィンドウに対応します。PyTorch対応やTPU Syncのオープンソース化など、ソフトウェア面の発表もあわせて行いました。
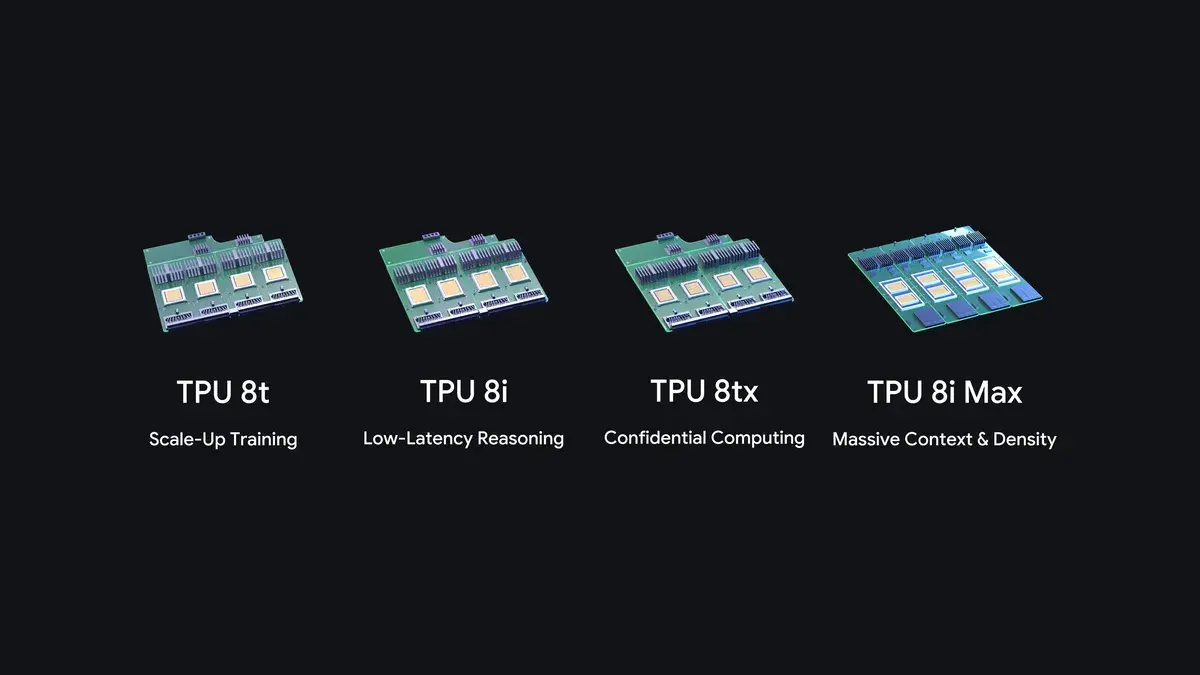
Googleは2026年11月9日、第8世代TPUのポートフォリオに「TPU 8tx」と「TPU 8i Max」の2システムを追加しました。4月のGoogle Cloud Nextで発表したTPU 8tとTPU 8iに続くもので、同じ年に4つのTPUシステムを投入するのは初めてです。8txは機密性の高いデータを扱う推論向け、8i Maxは数百万トークン規模のコンテキストを扱うエージェント向けと、用途をはっきり分けています。
「チップ」ではなく「システム」を増やす理由
今回の発表でGoogleが強調したのは、新しいチップと新しいシステムの違いです。チップの設計には数年単位の時間がかかる一方、システムはチップの周りに置くメモリやネットワーク、ストレージ、パッケージングの組み合わせで構成できます。
GoogleはTPUを最初から部品として扱えるように設計し、AI Hypercomputerの構成要素として組み替えられるようにしてきたと説明しています。そのため、顧客の新しい要望に対して数年ではなく数カ月で専用のスーパーコンピューターを用意できるとしています。TPUの顧客はフロンティアラボや金融トレーディング企業、小売、大学などおよそ100社に増えており、外部からの要望が設計に反映されるようになったことも背景にあります。
 画像引用元: Google Blog
第8世代TPU4モデルの役割分担
4つのシステムは、AIのライフサイクルのどこを担当するかで分かれています。TPU 8tと8iは前世代比でそれぞれ最大2.7倍の学習性能、80%高い推論の価格性能を実現したとされています。
| システム | 主な用途 | 特徴 |
|---|---|---|
| TPU 8t | 大規模な事前学習 | 電力あたりの有効な計算量(goodput)を最大化 |
| TPU 8i | 低レイテンシの推論 | チップ間通信の遅延を最大半分に削減 |
| TPU 8tx | 機密推論・小規模学習 | 8tと同じシリコンにハードウェアレベルの保護を追加 |
| TPU 8i Max | 巨大コンテキスト・高密度 | 8iのチップ2基を1パッケージに搭載 |
学習、推論、機密処理、長文脈処理という4つの軸に対して、それぞれ専用の選択肢を用意した形です。
TPU 8tx:処理中のデータも保護する機密推論
TPU 8txは、規制の厳しい企業や政府機関が、機密データと一緒にフロンティアモデルや自社モデル、エージェントを動かすためのシステムです。通常、データは保存時や通信時には暗号化されていても、処理する瞬間にはメモリ上で復号されます。8txはTPU 8tと同じシリコンを使い、第5世代のAMD EPYCをホストCPUとして組み合わせることで、処理中のデータやモデルの重みもハードウェアの層で分離・保護します。
ネットワークにはリアルタイム推論向けに開発した低レイテンシの「Boardfly」を採用し、TPU 8t比で最大2倍の低レイテンシを、性能低下をほぼ伴わずに実現したとしています。ひとつのシステム上で推論とファインチューニング、蒸留、強化学習を回せるため、機密データを別のクラスターへ移す必要もありません。
TPU 8i Max:2チップ構成で「メモリの壁」に挑む
TPU 8i Maxが狙うのは、いわゆるメモリの壁です。数十のエージェントがコードベース全体や数時間分の動画を同時に扱うような処理では、演算性能よりもメモリ帯域がボトルネックになりやすくなります。
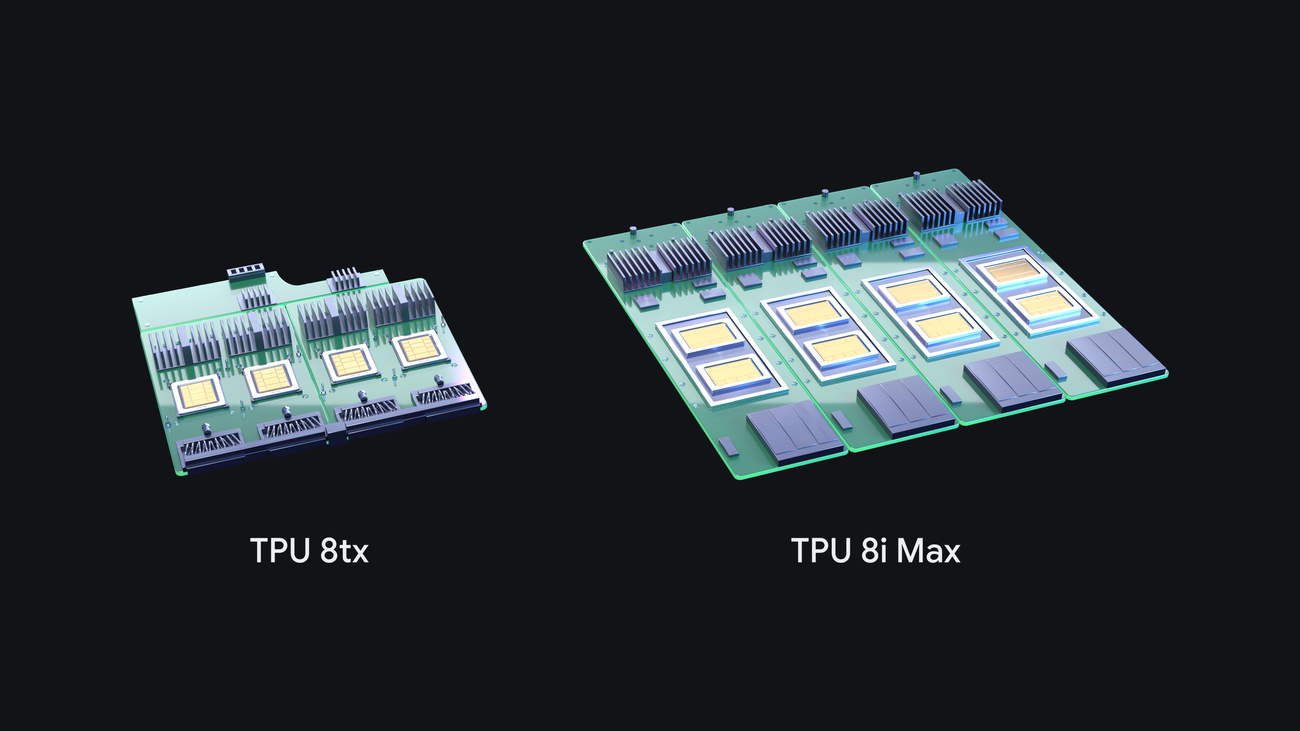
そこでGoogleは、低レイテンシのTPU 8iチップを2基、ひとつのパッケージにまとめました。演算性能、SRAM容量、HBM帯域がいずれもTPU 8iの2倍になり、大きな処理でもデータ待ちで止まりにくくなります。既存のラックの設置面積に2倍のシリコンを詰め込めるため、床面積あたり、電力あたりの計算能力も大きく高まります。
PyTorchユーザーにも開かれるTPU
ハードウェアと並んで、Cloud TPUのソフトウェア面の発表も目立ちました。Googleは先月オープンソース化した「TorchTPU」により、PyTorchのコードやHugging Faceのモデルがコードを書き換えずにTPUで動くとしています。vLLMやSGLang向けのTPUバックエンドも用意されています。
さらに、Claude CodeやCursor、Google Antigravityに組み込めるTPUエージェントスイートをプレビュー公開しました。自然言語でTPUへの移行やボトルネックの診断、カスタムカーネルの自動チューニングができます。待機中のエージェントのセッションを自動で退避させる「Agent Compute Engine」や、HBMやホストDRAM、共有ストレージをひとつのメモリ階層として扱う「TPU Sync」のオープンソース化も発表され、TTFTを90%以上短縮できるとしています。
インフラ選定への影響
今回の発表で、TPUは「Googleの社内向けアクセラレーター」から、用途別に選べる汎用的な選択肢へと一段近づきました。特に、PyTorchのコードをそのまま動かせる点は、これまでGPU前提で開発してきたチームにとって検討のハードルを下げる要素です。
金融や医療、公共分野などで、機密データを理由にクラウドでの生成AI活用を見送ってきた組織にとっては、TPU 8txが新しい選択肢になります。長いコンテキストを扱うコーディングエージェントや動画解析を運用しているチームは、TPU 8i Maxの提供時期や価格を追っておくとよいでしょう。来年度のインフラ予算を組む前に、自社のワークロードが学習、推論、機密処理、長文脈のどれに偏っているかを整理しておくと、比較がしやすくなります。
Our newest TPUs: 8tx and 8i Max, built for the agentic era
We’ve expanded our eighth generation TPU portfolio with TPU 8tx and TPU 8i Max, marking four new TPU systems in a single year.



