0:00 0:00
記事
Hugging Face、3D生成モデル「TRELLIS.2」のLoRA微調整ガイドを公開——靴188点の学習でF値0.28から0.80に改善
Hugging Faceが、画像から3Dモデルを作るTRELLIS.2を自前の3Dアセットで微調整するためのガイドとスクリプトを公開しました。形状を担う2つのモデルにだけLoRAを追加し、靴のソールの形を大きく改善しています。Hugging Face Jobsでも手元のGPUでも動くDockerイメージが用意されています。
Hugging Faceは2026年11月12日、画像から3Dモデルを生成する「TRELLIS.2」を、自分の3Dアセットで微調整するためのガイドを公開しました。前処理と学習のスクリプト、それらをまとめたコンテナが用意されており、クラウドで処理を実行できるHugging Face Jobsでも、手元のGPUでも同じように動かせます。
データセットをHugging Face Hubにアップロードしておけば、少ない引数でそのまま学習を始められます。スクリプトはGitHubのリポジトリでも公開されており、中身を書き換えて試すことも可能です。ガイドでは、スクリプトの仕組みまで順を追って解説しています。
汎用3Dモデルが苦手な「細部」を直す
3D生成は、ロボティクスやシミュレーション、映像、エンターテインメントなど幅広い分野で使われています。ただ、GLBやPLYといったファイル形式、NeRFや3D Gaussian Splattingといった表現方法が乱立しており、扱いが難しい分野でもあります。TRELLISは共通の内部表現を導入し、デコーダーで目的の形式に変換することで、この問題を解きました。後継のTRELLIS.2は、3D構造の表現力をさらに高めています。
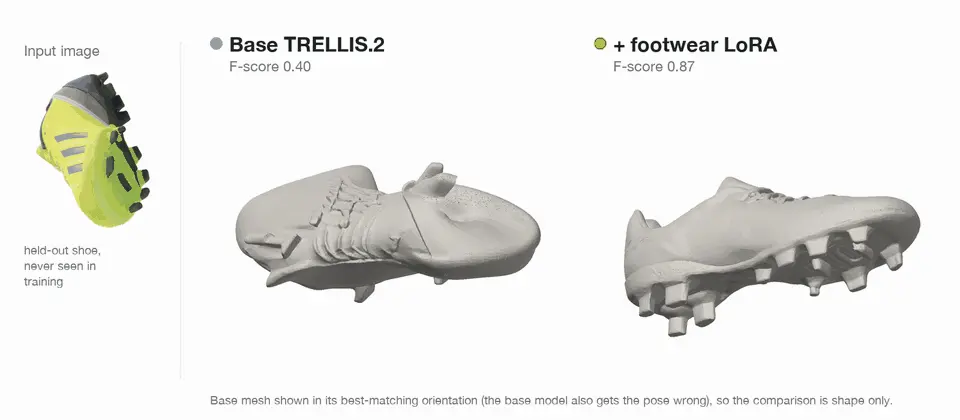
しかし、汎用モデルは特定の用途で重要な細部を間違えることがあります。家具のモデルで正確な形状が必要な場合などが典型です。今回の実験では、Google Scanned Objects(GSO)から靴188点を使いました。元のモデルが作る靴は、見た目はそれらしいものの、ソールの形が正しくなかったためです。
 画像引用元: Hugging Face Blog
TRELLIS.2の5つの処理段階
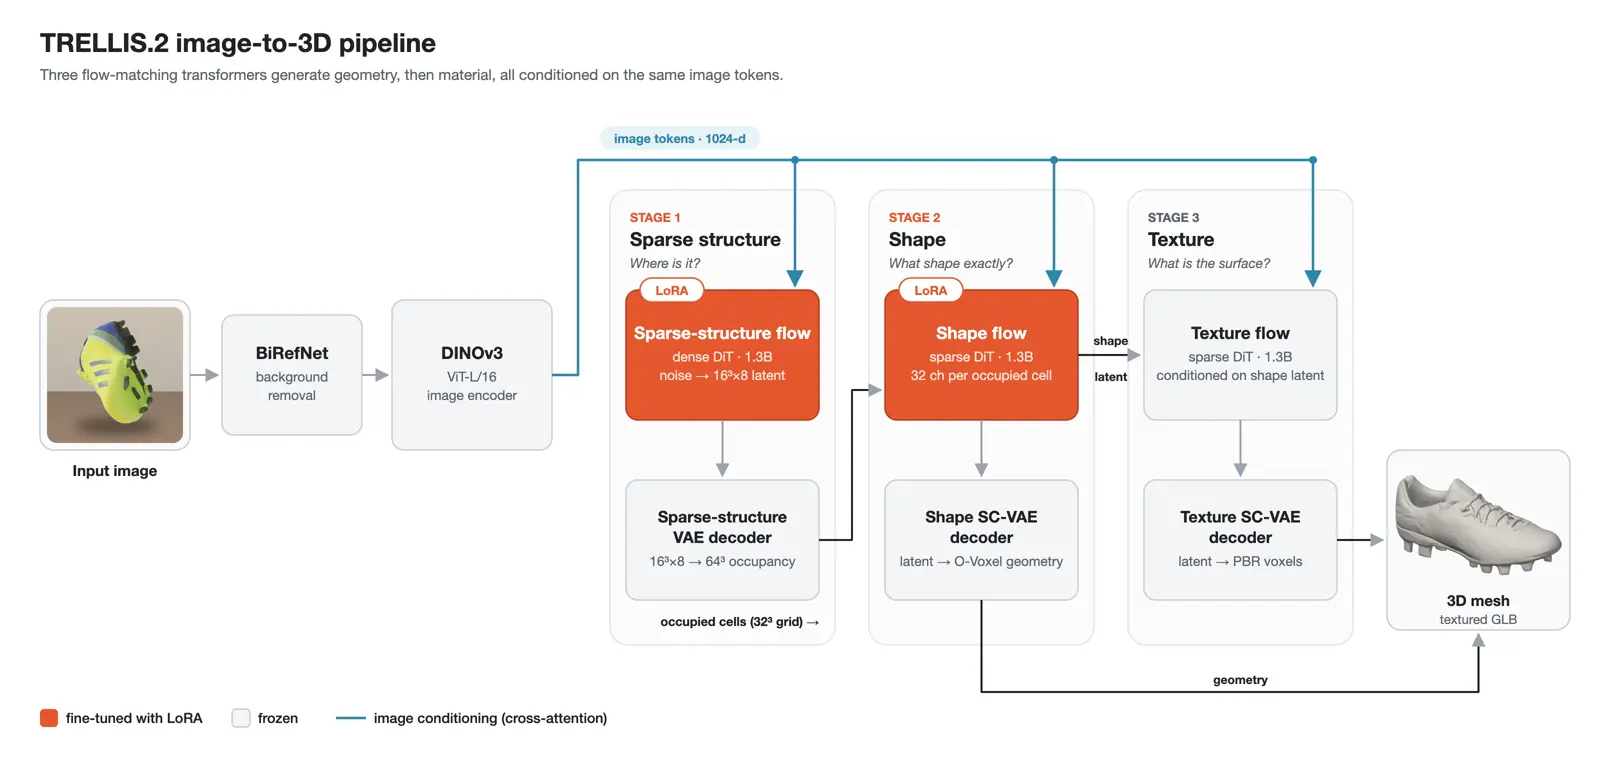
TRELLIS.2は、画像から3Dモデルを作るまでに5つの段階を踏みます。どこにLoRAを追加するかを決めるため、ガイドではまずこの流れを整理しています。
| 段階 | 処理内容 | LoRAの追加 |
|---|---|---|
| 1. 背景除去 | BiRefNetで入力画像の背景を取り除く | なし |
| 2. 画像の符号化 | DINOv3-Lで画像を特徴トークンに変換する | なし |
| 3. 大まかな構造 | Sparse Structure Flow DiTが64×64×64の占有グリッドを予測する | あり |
| 4. 詳細な形状 | Shape Flow DiTが512×512×512の解像度で形状を作る | あり |
| 5. 材質 | Texture Flow DiTが色や金属感、粗さを決める | なし |
最後に形状と材質を合わせ、テクスチャ付きのメッシュをGLBファイルとして書き出します。TRELLIS.2独自の「O-Voxel」形式は、物体の表面のボクセルだけを持つため軽く、メッシュとの相互変換も数秒で済むといいます。
 画像引用元: Hugging Face Blog
何を「凍結」するかが学習の鍵
ガイドが強調しているのは、何を微調整するかと同じくらい、何を凍結するかが重要だという点です。今回は形状を決める2つのDiTにだけLoRAを追加し、材質を担うTexture Flow DiTには手を付けていません。
理由は、データセットにある色のテクスチャに照明の効果が焼き込まれているためです。このまま学習させると、モデルが照明を表面の性質として覚えてしまったり、もともと持っていた能力を忘れる「破滅的忘却」が起きたりするおそれがあります。そもそも課題は靴の形にあり、色や質感は元のモデルで十分だったといいます。
LoRAは、元の重みを凍結したまま小さなアダプター行列だけを学習する手法です。学習するパラメータが減るため、必要なメモリも抑えられます。今回はPEFTライブラリを使い、2つのDiTで合計約930万のアダプターパラメータを学習しました。188点という小さなデータセットでは、全体を学習し直すより、元の能力を壊しにくいLoRAが適しているとしています。
前処理と学習はコンテナで実行
3Dモデルの環境構築は依存関係が多く手間がかかるため、前処理用と学習用の2つのDockerイメージが用意されています。前処理ではBlenderで各物体を16方向から描画し、学習時の条件画像にします。188点の処理には、A100(80GB)のジョブで約1時間かかりました。
学習はアダプターごとに別のジョブとして走らせます。A100を1基使い、Sparse Structureの学習に7.2時間、Shapeの学習に3.6時間かかりました。学習の様子はTrackioのダッシュボードで追えます。前処理済みの靴のデータセットも公開されているので、前処理を飛ばして学習だけ試すこともできます。
未学習の9点すべてで精度が向上
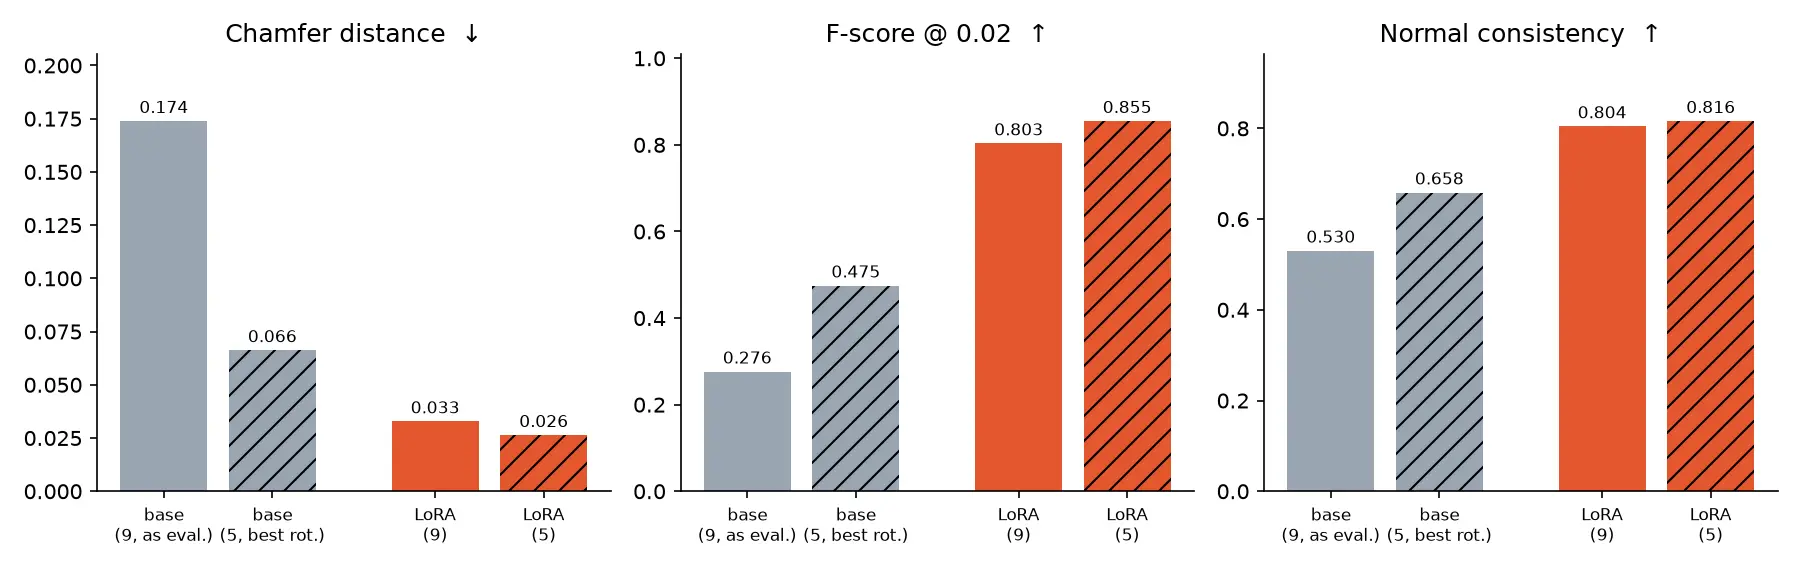
評価には、学習に使わなかった9点の靴を使いました。生成された形状と実際のスキャンデータの近さを、3つの指標で比べています。
 画像引用元: Hugging Face Blog
- F値(表面の重なり具合、高いほどよい): 0.276から0.803へ
- Chamfer距離(形状のずれ、低いほどよい): 0.174から0.033へ
- 法線の一貫性(面の向きの正確さ、高いほどよい): 0.530から0.804へ
2つのアダプターを組み合わせたモデルは、9点すべてでF値が元のモデルを上回りました。比較画像でも、ソールの形がスキャンデータに近づいていることが分かります。
自社の3Dアセットに合わせた生成へ
汎用の3D生成モデルを、自社の製品カテゴリーやゲームの素材に合わせて調整したいという需要は少なくありません。今回のガイドは、数百点規模の3Dデータと1基のGPUで、特定の用途に向けた改善がはっきり出ることを示しました。
自社で3Dアセットを持っているなら、まずは公開済みの靴のデータセットで手順を一通り試し、自社データに置き換えてみるとよいでしょう。どの段階を凍結するかの考え方は、TRELLIS.2以外の生成モデルを微調整するときにも役立ちそうです。

The Definitive Fine-Tuning Guide for 3D Generation Models
We’re on a journey to advance and democratize artificial intelligence through open source and open science.



