0:00 0:00
記事
IBM、LLM専用マークアップ「LLMON」を公開——Granite 4.1の3B/8Bでプロンプトインジェクション耐性を強化
IBMのGraniteチームは、LLMに文脈の構造を明示的に伝えるマークアップ言語「LLMON」と、それを理解するGranite 4.1ベースの3B/8Bプレビューモデルを公開しました。指示とデータを分離することで、間接的なプロンプトインジェクションをほぼ防げるとしています。
IBMのGraniteチームは2026年11月12日、LLMのために設計されたマークアップ言語「LLMON」をHugging Faceのブログで発表しました。あわせて、LLMONで書かれたテキストを読み書きできるよう学習した実験的なプレビューモデル「granite-4.1-3b-LLMON-preview」と「granite-4.1-8b-LLMON-preview」も公開しています。
LLMONは「LLM Object Notation」の略で、読み方は「レモン」です。システムプロンプトや過去の会話、ツールの応答、ユーザーデータなどが混ざり合うLLMの文脈に、はっきりとした構造を与えることを目的としています。
JSONはLLMのために作られていない
LLMの文脈は、長いやり取りの中でさまざまな要素で埋まっていきます。指示、検索で取ってきた文書、ツールの出力、出力形式の制約、推論の過程などです。しかし、その構造の多くはモデルにとって暗黙的なもので、JSONのようにLLMが読むことを想定していない形式で書かれています。
Graniteチームは、JSONはパーサーのために設計されたものだと指摘します。{や"、:といった構造を表す記号は普通の文章にも登場するため、モデルから見ると、文書中の引用符とフィールドを閉じる引用符は同じトークンです。入れ子の深さも括弧の数で表されますが、Transformerは長い範囲で数を数えるのが苦手です。こうした曖昧さが、特に小型モデルの不安定さや、プロンプトインジェクション攻撃の入り口になっているといいます。
特殊トークンで区切るXML風の記法
LLMONは見た目こそXMLに似ていますが、構造を表す区切りに、通常の文字ではなく予約された特殊トークンを使います。構造と中身がボキャブラリーの別々の部分に分かれるため、両者が混同されることがありません。
区切り用の特殊トークンは6種類で、タグの開始と終了、入れ子、参照を表します。各ブロックには2文字のIDが振られ、どのIDでも必ず2トークンで表せるよう工夫されています。
最大の特徴は「exec」ブロックです。プログラムで関数に引数を渡すように、「この指示を、このデータに対して、これらの条件のもとで実行し、結果をこのブロックに書く」という対応関係を明示します。従来のチャットテンプレートでは、ユーザーの発言はひとつの文字列にまとめられ、どこが指示でどこが対象なのかをモデルが推測する必要がありました。
指示とデータの分離で攻撃をほぼ無効化
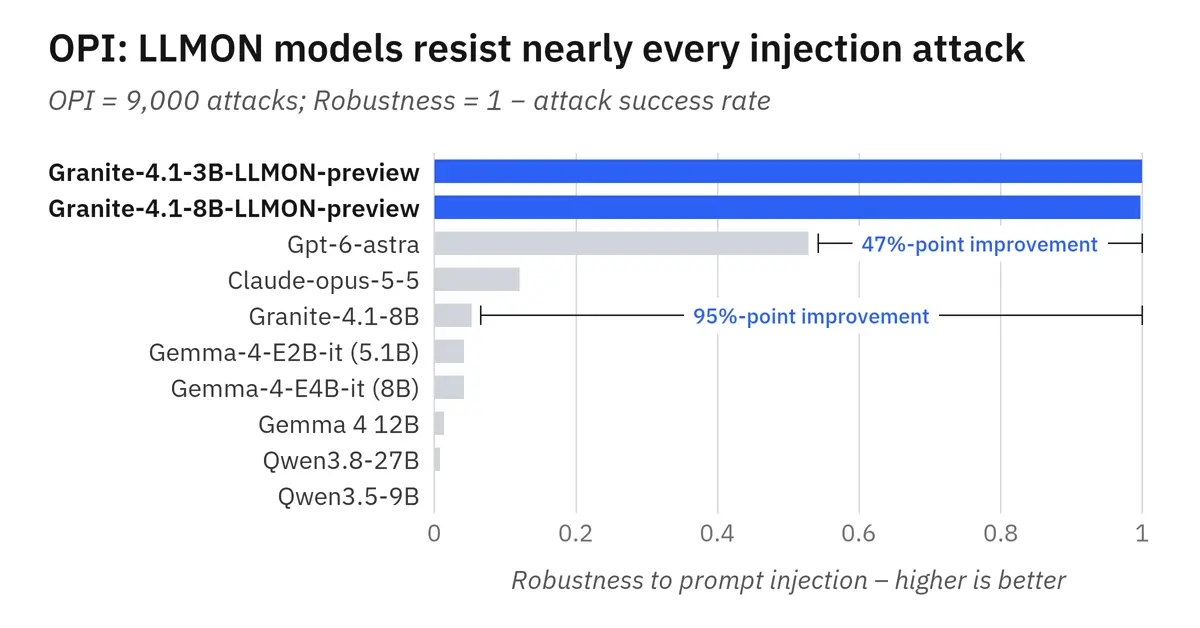
間接的なプロンプトインジェクションは、検索した文書やツールの応答、ユーザーデータなどに悪意のある指示を紛れ込ませる攻撃です。LLMONでは、execブロックから参照された指示だけが「従うべき命令」として扱われ、データとして渡された内容は「読むための材料」として扱われます。
 画像引用元: Hugging Face Blog
OPIベンチマークでの評価では、LLMON以外のモデルは高い確率で注入された指示を実行してしまったのに対し、LLMONモデルはこの問題を実質的に解消したとしています。テストした中で最も優秀なフロンティアモデルより47%、最も優秀なオープンソースモデルより95%多くの攻撃を防いだといいます。ASBやStruQといった他のベンチマークでも同様の傾向が見られたとのことです。
一般的な性能はGranite 4.1 Instructと同等
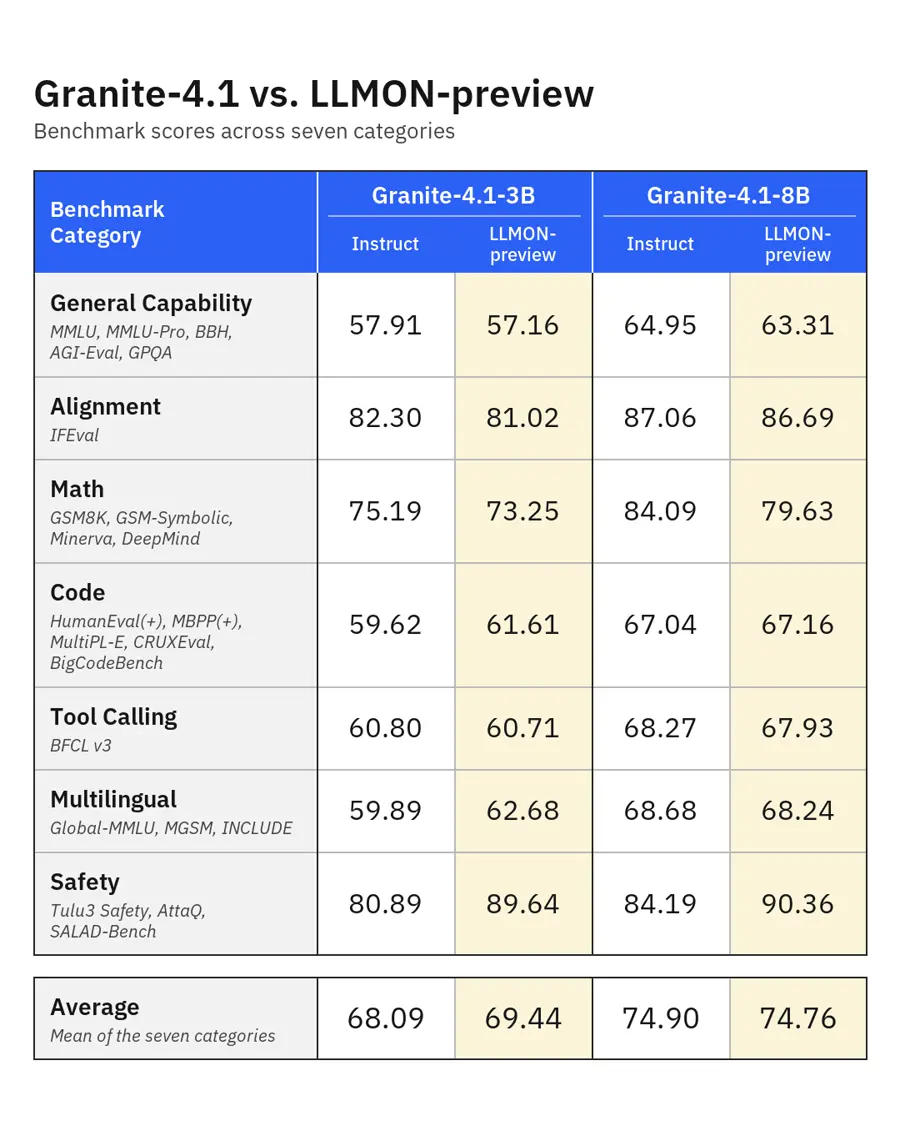
安全性を高めた代わりに一般的な能力が落ちる、ということはないとGraniteチームは説明しています。標準的なベンチマークでは、LLMONモデルはGranite 4.1 Instructとほぼ同等の性能を示しました。
 画像引用元: Hugging Face Blog
モデルはリリース済みのInstructモデルではなく、Granite 4.1のベースモデルから学習しています。一般的な指示チューニング用コーパスをLLMON形式に変換し、あえてexecブロックから参照されない「おとり」の指示やデータを混ぜて学習させました。その後、GRPOによる5段階の強化学習と、インジェクションへの応答から作った約1000組のペアによるDPOを行っています。ただし、これは学習で身につけた振る舞いであり、保証された動作ではないと注意書きしています。
独自の語彙を定義してLoRAで拡張も可能
LLMONは決まったスキーマに縛られません。用途に合わせてタグ名や構造を自分で決め、LoRAアダプターを学習させて読み書きさせることもできます。
ブログでは、理科の実験課題をテキストで解くベンチマーク「ScienceWorld」での例を紹介しています。目標、計画のルール、部屋の状態、持ち物、次の行動といったタグを定義し、模範解答をそのタグで書き直してLoRAを学習させたところ、未知のゲームでも新しい語彙で次の行動を出力できたといいます。
既存のJSONをLLMONに変換して元に戻せる変換ツールも用意されているので、JSON前提のパイプラインからでも移行しやすくなっています。
RAGやエージェントを作る人は試す価値あり
LLMONプレビューモデルには専用のチャットテンプレートが付属しており、通常のチャットモデルと同じようにapply_chat_templateを呼ぶだけで使えます。メッセージの各部分に「instruction」「data」「requirement」といった名前を付ければ、テンプレートが自動でLLMONのブロックに変換してくれます。
あくまで評価・検証向けの実験的なプレビューで、本番利用は想定していません。それでも、外部の文書やツールの出力を扱うRAGやエージェントを開発していて、プロンプトインジェクション対策に頭を悩ませている人には、試してみる価値がありそうです。モデルはHugging Faceで、ツールキットはGitHubで公開されています。

LLMON: An LLM-Native Markup Language, now in Granite 4.1 3B and 8B
A Blog post by IBM Granite on Hugging Face



