0:00 0:00
記事
Meta、広告配信の計算資源をMLで割り振る「Intelligent Delivery」を解説——AIエージェントが最適化の8割を担う仕組みも
Metaが広告ランキングの計算資源をシステム全体で最適に割り振る「Intelligent Delivery」の仕組みを公開しました。リクエストごとの効果を予測するモデル、リージョンからホスト内までの3層の割り当て、AIエージェントによる最適化ループで構成され、ランキング性能を約10%押し上げたといいます。
Metaは2026年11月11日、エンジニアリングブログ「Engineering at Meta」で、広告配信の計算資源をシステム全体で最適に割り振る仕組み「Intelligent Delivery」を公開しました。どの広告リクエストに、どのモデルやハードウェアの計算資源を回せば最も効果が高いのかを機械学習で予測し、配信基盤全体に反映させるシステムです。
Metaによると、Intelligent Deliveryは2017年から2026年上半期までに、モデルやシステム自体の改良とは別に、主要な面での広告ランキング性能を約10%押し上げてきました。今回のブログでは、計算資源の効果を予測するモデル、資源を動かす多層の仕組み、そしてAIエージェントによる最適化の3つが紹介されています。
計算資源がモデルの成長に追いつかない
広告ランキングのモデルは、ハードウェアの進化を上回る速さでLLM並みの規模に近づいています。候補となる広告の数も増え、配信の仕組みも複雑になる一方で、使える計算資源はそれほどの速さでは増えません。限られた処理能力と厳しいレイテンシの制約の中で、強力なモデルをどう効率よく動かすかが課題になっています。
Metaは、この問題を難しくしている性質として3つを挙げています。同じ計算資源でも効果がリクエストや状況によって大きく変わること、個々の部分を最適化しても全体の最適にはならないこと、そして新しいモデルやハードウェアが入るたびに最適な状態そのものが動いてしまうことです。Intelligent Deliveryは、この3つにそれぞれ対応する仕組みで構成されています。
6Bパラメータの「Resource Core Model」
1つ目は、リクエストごとに計算資源の効果を見積もる仕組みです。以前は、表示面や文脈といった属性でリクエストを大まかなグループに分け、エンジニアがグループごとに割り当てのルールを決めていました。しかし、新しいシグナルが増えるたびにルールが膨れ上がり、数千のシグナルが絡み合う非線形な関係も捉えきれませんでした。
そこでMetaは、どのリクエストが追加の計算から最も恩恵を受けるのか、資源の設定を変えると成果や処理性能がどう変わるのか、という2つの機械学習の問題に置き換えました。中心となるのが「Resource Core Model」で、6Bのスパースパラメータと20Mのデンスパラメータを持つ深層学習モデルです。候補の取得前に1回だけ実行され、配信の各段階で共有されます。オフライン評価では、効果の高いリクエストを見分ける精度が従来の本番モデルより約20%向上しました。
リージョンからホスト内まで3層で割り当て
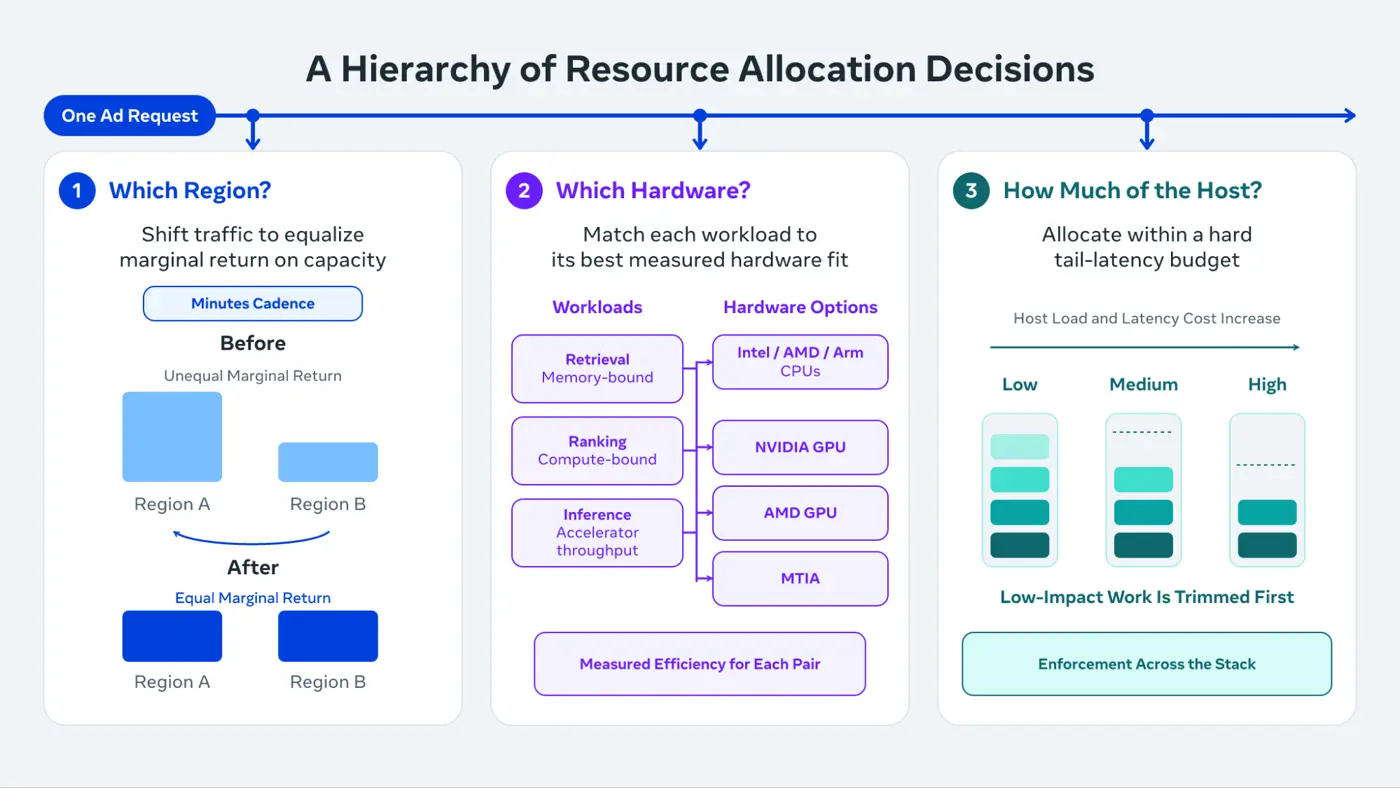
2つ目は、予測を実際の資源配分に変える仕組みです。Metaの広告配信は、世界中の多数のリージョン、複数世代のハードウェア、数百万台のホストにまたがっています。1つの仕組みで全体を制御するのは難しいため、問題を階層に分け、層ごとに専用の判断エンジンを用意しました。
 画像引用元: Engineering at Meta
| 判断の層 | 決めること | 主な手法 |
|---|---|---|
| リージョン | どのデータセンター地域で処理するか | 数分周期でトラフィックを移し、各リージョンの限界効率をそろえる |
| ハードウェア | どのCPUやアクセラレーターで動かすか | ワークロードとSKUの組み合わせごとに効率を測り、割り当てを解く |
| ホスト内 | そのマシンの資源をどれだけ使うか | 成果とコストを予測し、レイテンシ予算内で効果を最大化する |
ハードウェアの層では、Intel、AMD、ArmのCPUに加え、NVIDIAやAMDのアクセラレーター、自社開発のMTIAが対象になります。ホスト内の制御はカーネルのスケジューラーからアプリケーションのスレッドプールにまで及び、負荷が高まると資源を多く使うわりに効果の低い処理から削られていきます。
AIエージェントが最適化の8割を担当
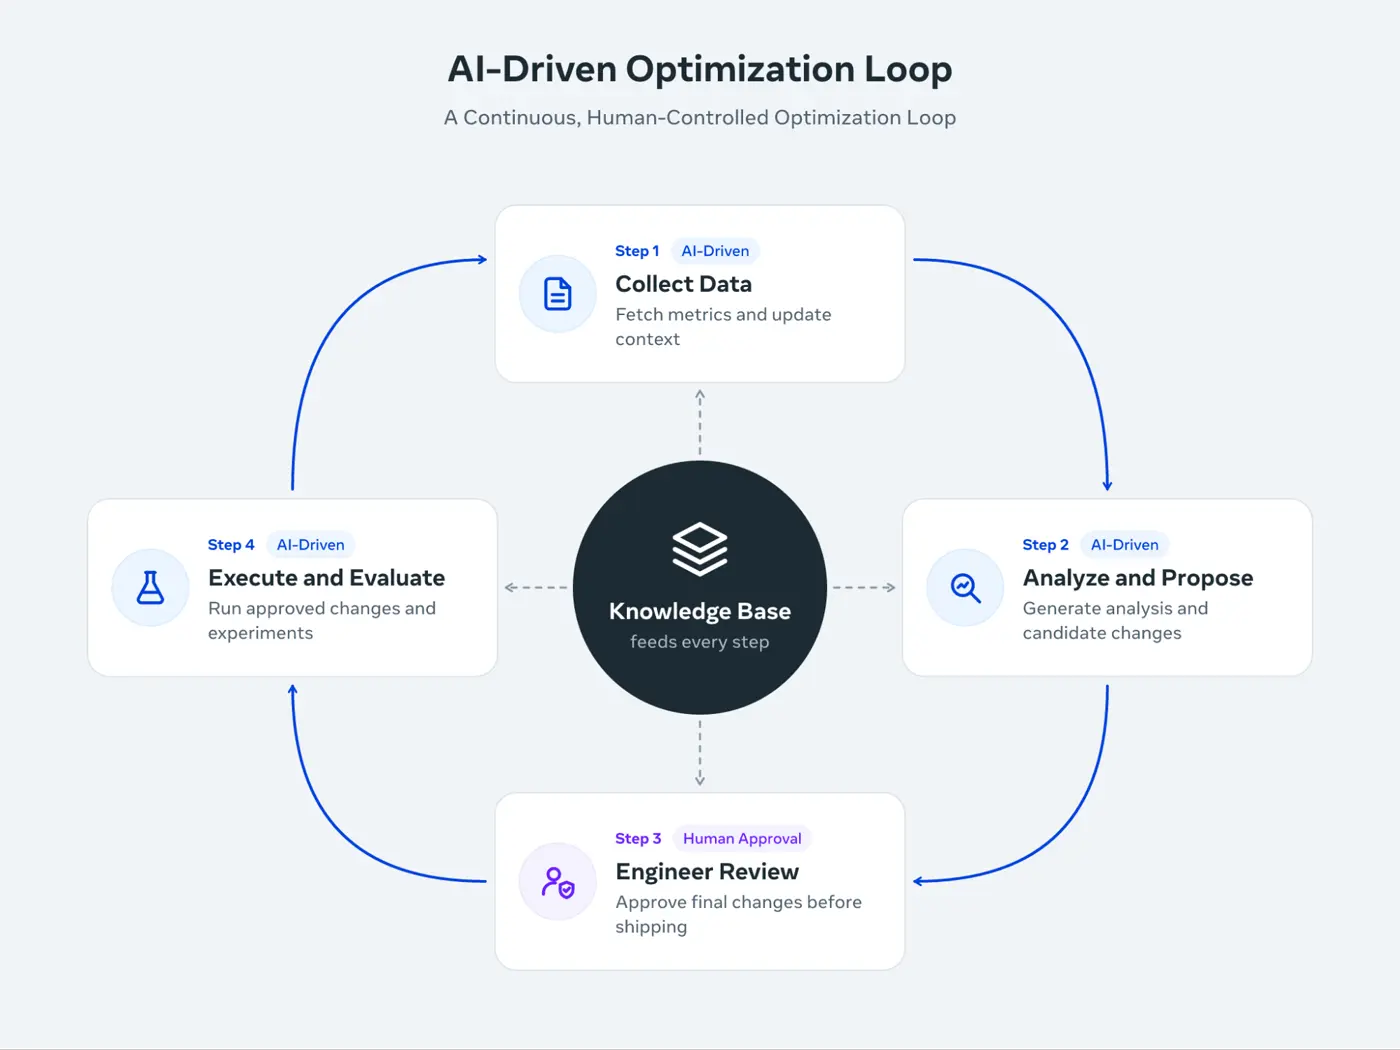
3つ目は、新しいモデルやハードウェアを入れるたびに設定を調整し直す最適化のループです。調整できる項目は数百万次元に及び、すべてを総当たりで試すことはできません。これまではエンジニアの経験に頼るか、限られた項目だけを扱う制約付き最適化を使ってきましたが、どちらも探索の範囲が広がる速さに追いつけませんでした。
現在は、AIエージェントがシステム全体を監視し、仕組みのソースコードや設計書、10年分の実験ログを長いコンテキストで読み込んで、試す価値のある変更をいくつかに絞り込みます。エージェントは実験の設計と実行まで担い、最終的な変更はエンジニアがレビューして承認します。2026年上半期には最適化の約20%にエージェントが関わり、最も自動化が進んだ仕組みではエンジニアリング作業の約80%を担っています。最適化のサイクルは数カ月から数週間に短くなったといいます。
 画像引用元: Engineering at Meta
大規模な推論基盤を持つ企業への示唆
Metaは今後の課題として、リクエストの理解と配信の判断を1つのモデルに統合し、リアルタイムで処理することを挙げています。また、生成型広告モデル「GEM」のような大規模なランキングモデルはGPUで動くことが増えており、CPU向けに作ってきた調整の手段をGPU向けに作り直す必要があるとしています。
広告に限らず、推薦や検索、LLMの推論サービスを運用している企業にとっても、考え方は参考になります。すべてのリクエストに同じだけ計算資源を使うのではなく、効果の見込みに応じて配分を変えるという発想です。自社の基盤で「どのリクエストに計算を足すと成果が伸びるのか」を測れているかどうか、まずは確認してみる価値がありそうです。
Intelligent Delivery: Making Every Unit of Compute Serve Better Ads
Ads ranking models are growing toward LLM scale faster than the hardware to run them can keep up. An extra unit of compute has more impact on some ad requests, models, and chips than on others. The…



