0:00 0:00
記事
Meta、LLDBでCPUとGPUをまたいでデバッグできる仕組みを公開——ベンダー非依存のプラグイン構造をLLVMへ
Metaは、CPUとGPUの両方で動くアプリケーションをひとつのLLDBセッションでデバッグするための、ベンダー非依存のアクセラレータープラグイン構造を公開しました。CPUとGPUを別々のターゲットとして扱いながら、開発者にはひとつのデバッグ体験として見せる設計で、共通部分の多くはすでにLLVMへ取り込まれています。
Metaは2026年11月9日、エンジニアリングブログで、CPUとGPUにまたがって動くアプリケーションをLLDBでデバッグするための新しい仕組みを公開しました。lldb-serverにベンダー非依存のアクセラレータープラグイン構造を追加し、共通のデバッガー基盤とハードウェア固有のデバイス制御を切り分けています。CPUとGPUを別々のデバッガープロセスとして扱いながら、ひとつのデバッグセッションとして見せるのが特徴です。
なぜGPUのデバッグは難しいのか
最近のAIアプリケーションは、ひとつの場所だけで動くことはほとんどありません。高水準のフレームワークから始まった処理が、CPUのネイティブコードとGPUのカーネルを行き来します。バグがその境界をまたいだとき、開発者はホスト側とデバイス側を同時に理解する必要があります。
従来のデバッガーは、ひとつのプロセスにはひとつのアーキテクチャがあり、スレッドやレジスター、メモリの見え方も一貫しているという前提で作られてきました。ところがGPUでは、ホストがx86-64で動いていてもカーネルはまったく別の命令セットを使います。数千のレーンが足並みをそろえて実行され、ホストとデバイスのポインターが別のアドレス空間を指すこともあります。同じ0x1000というアドレスが、CPUとGPUでまったく別の場所を指す場合もあるわけです。
ベンダーごとのデバッガーからの脱却
これまでは、GPUベンダーがそれぞれ専用のデバッガーを用意してきました。AMDのROCgdbやNVIDIAのCUDA-GDBがその代表です。どちらも自社のプラットフォームに深く対応していますが、デバッガーとして共通の機能をそれぞれが別々に実装し、保守し続けなければなりません。
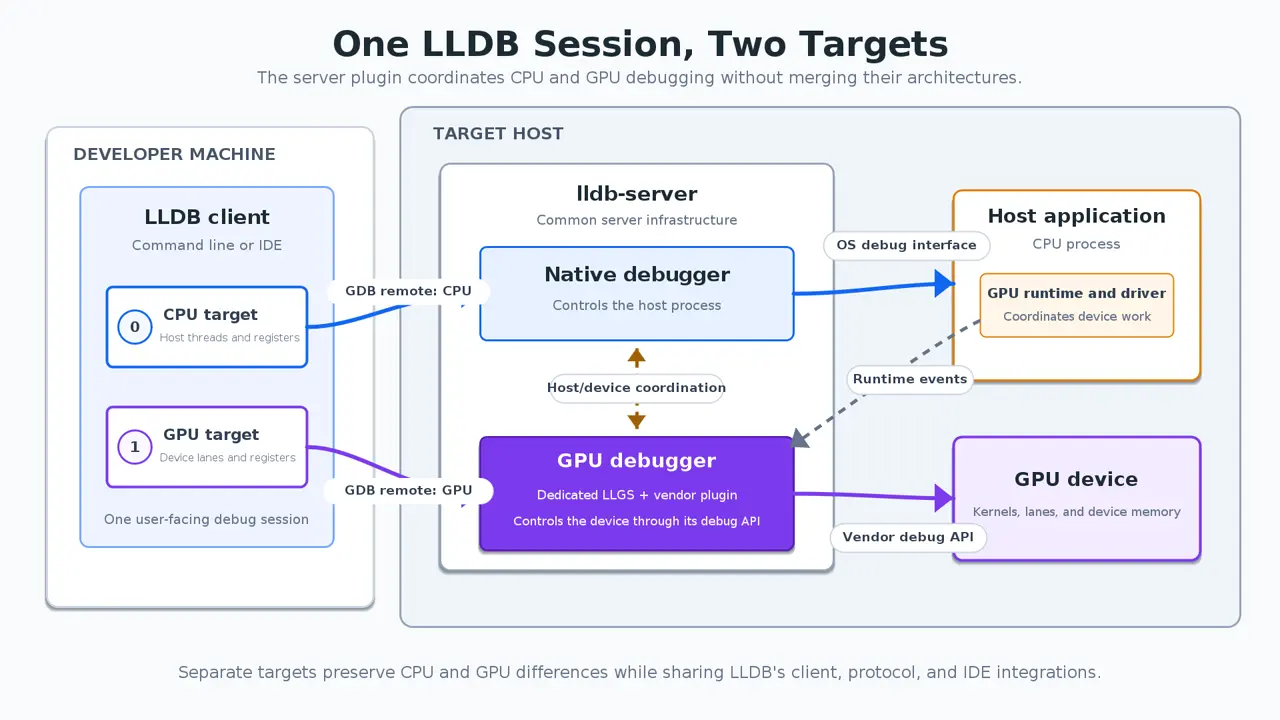
Metaが選んだのは、LLDB側に共通のアクセラレータープラグイン構造を用意するという方法です。LLDBのクライアントはベンダーに依存しないまま、コマンドラインやリモートプロトコル、シンボル処理、IDE連携の改善がすべてのアクセラレーターに行き渡ります。各ベンダーは、自社のハードウェアとドライバーに固有の部分だけを実装すればよくなります。
 画像引用元: Engineering at Meta
2つのターゲット、ひとつのデバッグ体験
新しい構造では、CPUとアクセラレーターを別々のLLDBターゲットとして表現します。それぞれのターゲットが独自のアーキテクチャを持ち、スレッドやレジスター、アドレス空間、実行状態を管理します。デバッグの流れは次のとおりです。
- LLDBがlldb-serverに接続し、利用できるアクセラレータープラグインを検出する
- プラグインが、GPUのデバッグを開始できるタイミングなどを捉えるための内部ブレークポイントをホスト側に設定する
- ホストがその地点に達すると、プラグインがベンダーのデバッグAPIを初期化する
- LLDBがアクセラレーター用の2つ目のターゲットを作成して接続する
公開されたHIPのサンプルでは、GPUモジュールが読み込まれた時点で保留中のブレークポイントが解決され、GPU側のバックトレースをそのまま表示できています。CPUだけを使うアプリケーションでは従来どおりの経路で動き、余計なオーバーヘッドは発生しないとしています。
ハードウェアなしでもテストできるモック
Metaは、専用のハードウェアがなくてもこの流れを確認できるモックのアクセラレータープラグインも作りました。LLVMのテストスイートで、プラグインの検出やブレークポイントの連携、接続の作成、基本的なデバイス状態を検証できます。特定のGPUに依存せずに共通基盤をレビューし、テストできる点が開発を進めるうえで重要だったと説明しています。
この枠組みは、実行中のプロセスに対するデバッグだけでなく、GPUのコアダンプを使った事後解析にも対応しています。Metaは異なるハードウェアとソフトウェアスタックを持つGPUを社内で運用しており、そのデバッグ作業がすでにこの構造の上で進んでいることが、設計の妥当性を裏付けているとしています。
LLVMへの取り込み状況と今後
執筆時点で、共通の枠組みの大部分はすでにLLVMのアップストリームに取り込まれています。lldb-serverのプラグインインターフェース、プラグインの検出や初期化、GPU接続を作成するためのGDBリモートパケット、CPUとGPUのデバッガープロセスを関連付ける仕組み、複数アドレス空間のサポート、ハードウェアに依存しないモックテストなどが含まれ、残りも近く取り込む予定です。
Metaは今後、残りの共通基盤のアップストリーム化を終え、その上に構築するベンダー統合を広げていく方針です。新しいハードウェアをLLDBに対応させるのに、別のデバッガーを作って保守するのではなく、ベンダー固有のプラグインを書くだけで済む状態を目指しています。
GPUコードを書く開発者への影響
PyTorchのカスタム演算子や推論エンジンのカーネルを書いている開発者にとって、CPUとGPUの境界で起きる不具合は再現も調査も手間がかかる領域です。複数のGPUベンダーを併用している環境では、デバッガーごとに操作を覚え直す負担もあります。
LLDBひとつでホストとデバイスを行き来できるようになれば、IDEのデバッグ機能もそのまま使えるようになります。社内でAMDとNVIDIAのGPUを使い分けているチームは、今後のLLVMのリリースノートでGPUデバッグ関連の項目を追っておくとよいでしょう。ベンダーのプラグインがそろってきた段階で、デバッグ手順書の見直しを検討する価値があります。
Extending LLDB to Debug Applications That Span CPUs and GPUs
We built a vendor-neutral accelerator plugin architecture in lldb-server for debugging applications that span CPUs and GPUs. It separates shared debugger infrastructure from hardware-specific devic…