0:00 0:00
記事
Meta、Triton拡張「TLX」の設計を公開——手書きCUDA並みの性能をPythonで、広告モデル学習でMFU20〜25%
MetaはTritonに低レベルの実行制御を加える拡張「TLX(Triton Low-Level Extensions)」の詳細を公開しました。ワープグループ単位でGPUの実行を組み立てる新しいプログラミングモデルを採用し、広告モデルの学習やレコメンドの推論、LLMの事前学習で本番運用されています。
Metaは2026年11月10日、エンジニアリングブログで、GPUカーネル言語Tritonの拡張「TLX(Triton Low-Level Extensions)」をどのように作ったのかを詳しく解説しました。TLXは、Tritonの書きやすさを保ったまま、最新GPUの実行の仕組みを明示的に制御できるようにする拡張です。すでにMetaの広告モデルの学習、レコメンドの推論、大規模言語モデル(LLM)の事前学習で本番運用されています。
Tritonが社内の主役になった背景
Metaの機械学習の処理は、PyTorchを中心にしたソフトウェアスタックの上に作られています。モデルのコードはグラフの取得や最適化、コンパイルを経てGPUカーネルに変換されます。その過程で、Tritonは実験的な言語から欠かせない部品に成長しました。
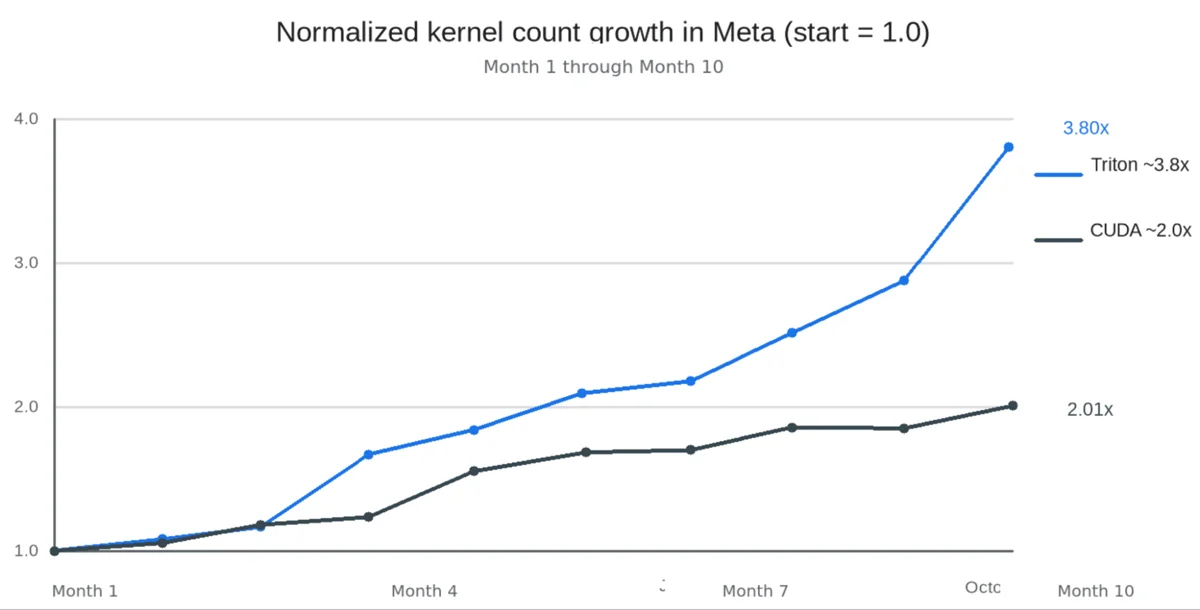
ブログによると、10カ月間でTritonで書かれたカーネルの数は約3.8倍に増え、CUDAの約2倍を大きく上回りました。カーネルの最適化はもはやGPUの専門家だけの仕事ではなく、機械学習エンジニアが日常的にボトルネックを調べ、数時間単位で改善を繰り返す作業になっているといいます。
 画像引用元: Engineering at Meta
ハードウェアの進化に言語が追いつかない問題
課題になったのは、GPUの進化の方向です。NVIDIAのHopperはワープの役割分担(ワープスペシャライゼーション)やTMAを導入し、BlackwellはTensor Memory(TMEM)やクラスタ単位の実行などをさらに加えました。これらは単なる新命令ではなく、高速なカーネルの組み立て方そのものを変える機能です。
CUDAならこうした構造を書けますが、アーキテクチャごとに大量の調整コードが必要になります。一方のTritonは生産性が高いものの、多くの実行の関係がコンパイラの内部に隠れていました。新しい世代のGPUが出るたびに、コンパイラの対応を待つか、専門的な実装に頼るかの二択を迫られていたのです。
「MIMW」という中間のプログラミングモデル
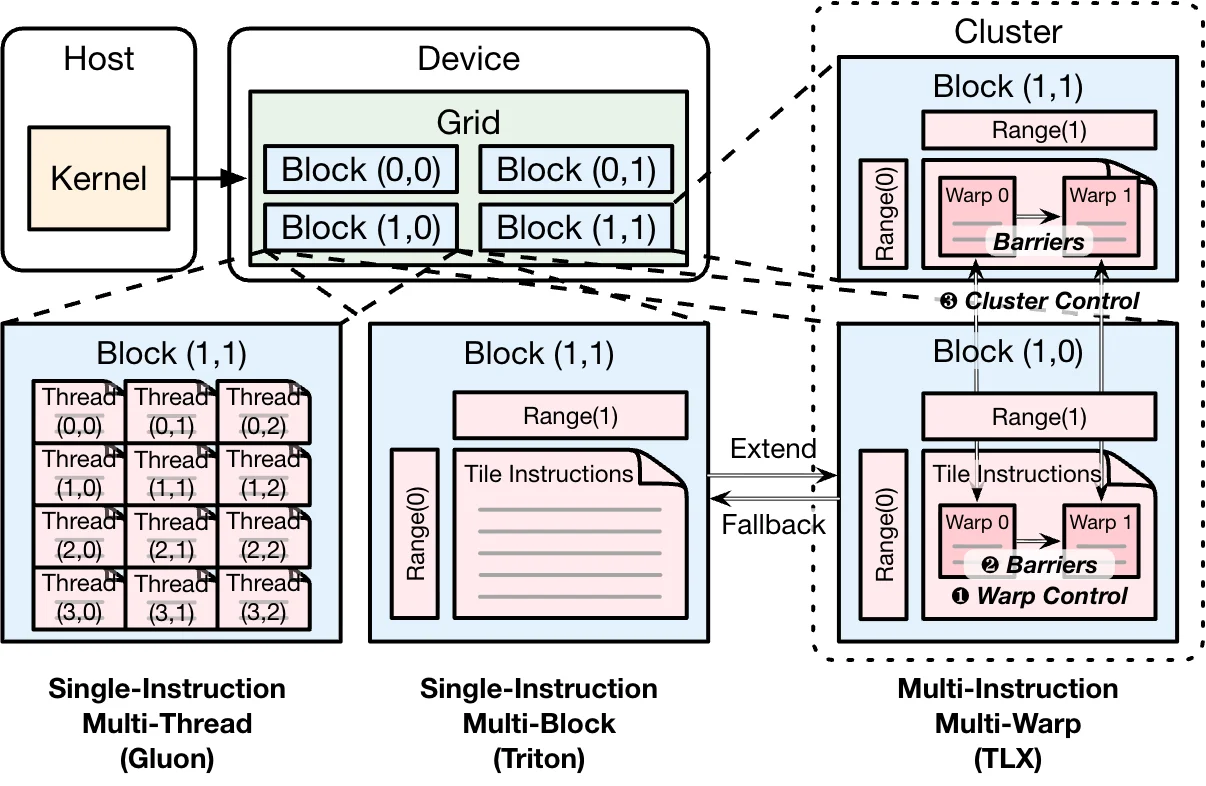
Metaはこの状況を、適切な抽象化が欠けている問題だと捉えました。CUDAのSIMTはスレッド単位で細かすぎ、TritonのブロックベースのモデルであるSIMBは粗すぎるという整理です。そこで、ワープグループを実行の基本単位とする「MIMW(Multiple Instructions, Multiple Warps)」というモデルを定義しました。
TLXは、このMIMWをTritonの上に実装したものです。計算の中身はこれまでどおりTritonのテンソル演算で書き、実行の調整やメモリ転送、同期を細かく制御したい部分にだけTLXの構文を使います。Metaは「Tritonは何を計算するかを、TLXはその計算をどう組み立てるかを担う」と説明しています。
 画像引用元: Engineering at Meta
本番環境での成果
ブログでは、本番で得られた成果が具体的に示されています。
- 広告モデル(GEM)の学習: 数千基のNVIDIA Blackwell GPUで、エンドツーエンドのMFU(演算器の使用効率)20〜25%を達成
- GEM内のアテンション系カーネル: 複数の処理を1つのカーネルにまとめ、順伝播を最大2倍高速化
- レコメンド推論(IKBO): 線形圧縮のカーネルでNVIDIA H100上4倍の高速化。計算負荷の大きい部分の遅延を最大3分の2削減
- LLMの事前学習: 混合エキスパート(MoE)向けの分散グループ化GEMMカーネルが、大規模なGPU群で長期間稼働
Metaは、TLXの性能は手作業で調整したCUDAとほぼ同等である一方、開発のスピードは大幅に速いとしています。IKBOの実装は、数カ月ではなく数週間で完成したということです。
対応GPUと今後の計画
TLXが現在対象としているのは、NVIDIAのHopperとBlackwell、AMDのMI300とMI350Xです。今後は両社の新世代GPUに加え、Meta独自のアクセラレーターMTIAへの対応も進めるとしています。MIMWの考え方自体は特定のハードウェアに依存しないためです。
さらに、ワープグループの組み立てを上位のパターンから自動で推論する「auto-TLX」のような仕組みや、torch.compileのバックエンドとしてTLXを使えるようにする構想も示されました。実現すれば、PyTorchのコードを書くだけでTLXで最適化されたカーネルが得られるようになります。
GPUカーネルを書くエンジニアへの示唆
Tritonでカーネルを書いているチームにとって、今回の解説は最新GPUの性能を引き出すための具体的な指針になります。Hopper以降のGPUでTritonの性能が頭打ちになっている場合、その原因はコンパイラが隠している実行の調整部分にあるかもしれません。
Metaは、TLXを使ったカーネルの詳しい事例をPyTorchブログの関連記事で紹介しています。いきなり導入を決めるより、まず自社で最も時間のかかっているカーネルを洗い出し、ワープスペシャライゼーションで改善できる余地があるかを確かめるところから始めるのが現実的です。開発体験への投資を性能と同じくらい重視したというMetaの姿勢も、社内ツールを作るうえで参考になります。
How We Built TLX: A Hardware-Native GPU Compiler for Production ML at Scale
Triton Low-Level Extensions (TLX), is an extension to Triton that helps engineers optimize GPU performance while preserving Triton’s productive programming model. TLX introduces explicit war…



