0:00 0:00
記事
NYTら新聞各社、ブラウザ「Brave」を提訴——AI企業への記事提供とペイウォール回避が争点に
The New York Timesなど複数の新聞社が、Braveブラウザの開発元を提訴したとThe Vergeが伝えました。無断で収集した記事をAnthropicやPerplexityなどのAI企業へ有料で提供したことや、ペイウォールを回避する機能が問題視されています。
The New York Timesをはじめとする複数の新聞社が、プライバシー重視のWebブラウザ「Brave」を開発するBrave Softwareを提訴したと、The Vergeが伝えました。報道はReutersによるものです。AIの学習に使うための違法なスクレイピングと、ユーザーに新聞社のペイウォール(有料記事の壁)を回避させている点が訴えの柱となっています。
「Brave Index」をAI企業へ有料提供
New York Daily News、Chicago Tribune、Orlando Sentinelを運営する各社の訴状によると、Brave Softwareは、Webサイトを収集して作った独自の検索インデックスを収益化しているといいます。その手段の一つが、AI企業に「Brave Indexのリアルタイムなオンラインコンテンツ」への有料アクセスを提供することです。
AI企業はこのインデックスを、モデルの学習に使ったり、ユーザーの質問に答えるためにコンテンツを参照したり、あるいはその両方に利用しているとされます。訴状は、Braveが「盗まれた著作物」を「多くの」AI企業に提供してきたと主張しており、名前が挙がった企業は次のとおりです。
| 訴状で名前が挙がったAI企業 | 主なサービス |
|---|---|
| Anthropic | Claude |
| Perplexity | AI検索 |
| Mistral | Le Chat、各種LLM |
| xAI | Grok |
| Cohere | 企業向けLLM |
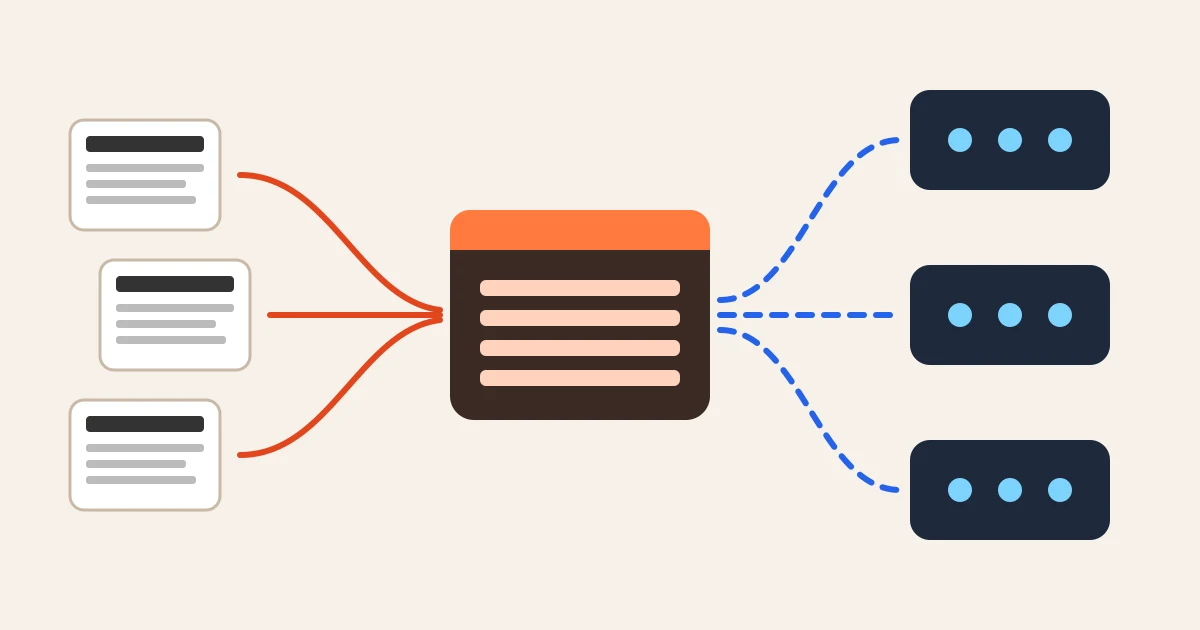
訴状で主張されている構図をもとに作成したイメージ図
ペイウォール回避機能も問題に
もう一つの争点が、Braveブラウザに搭載された「Paywall blocker」です。訴状によると、Braveはこの機能で「数百の主要な出版社」の記事にアクセスできるとうたっているといいます。
訴状は「Braveは出版社のサイトにアクセスする許可を一度も求めておらず、ましてや記事をコピーしてユーザーや他のAI企業に提供する許可など得ていない」と指摘しています。さらに、ユーザーに同意なくペイウォールを回避させているうえ、出版社がBraveのアクセスを遮断できないようにする措置まで講じていると主張しています。著作物の利用に対する対価も一切支払われていないとしています。
NYTは「再三の要請を無視した」と主張
New York Timesの広報担当であるGraham James氏は声明で「AIの倫理的で責任ある利用と開発を支持しているが、Braveは確立された著作権法を軽視し、侵害行為をやめるよう求めたTimesの再三の要請を無視してきた」とコメントしました。そのうえで、自社製品のために記事を盗み、それを世界で最も有力で資金力のある生成AI企業に提供したことの責任を問うために提訴したと説明しています。
一方、The Vergeの取材に対して、Brave、Anthropic、Mistral、Cohereなどはすぐには回答していません。Perplexityの最高コミュニケーション責任者であるJesse Dwyer氏は「New York Timesは弁護士に払いすぎで、記者への支払いが足りない」と反論するコメントを出しています。現時点では訴えはあくまで原告側の主張であり、裁判所の判断が出たわけではありません。
Braveとはどんなブラウザか
Braveは、JavaScriptの生みの親でMozillaの共同創業者でもあるBrendan Eich氏らが立ち上げたブラウザです。Chromiumをベースに、広告やトラッカーを標準でブロックする機能を備え、プライバシーを重視するユーザーから支持を集めてきました。
同社は2021年に独自の検索エンジン「Brave Search」を公開し、GoogleやBingに頼らない自前のWebインデックスを構築しています。このインデックスを外部の開発者が使える「Brave Search API」も提供しており、AIチャットボットに最新のWeb情報を参照させる用途での採用が広がっていました。今回の訴訟は、まさにこのAPI事業が、新聞社の記事を無断で再配布する仕組みになっていると主張するものです。
AI向けデータ供給の「中間業者」にも矛先
これまで報道機関による著作権訴訟は、OpenAIなどのAI開発企業を直接相手取るものが中心でした。今回は、検索インデックスを通じてAI企業にデータを供給する立場の企業が訴えられた点が特徴です。AI企業がWebの情報を取り込む経路は、自社のクローラーだけでなく、外部の検索APIやデータ提供事業者にも広がっており、その経路全体が法的な検証の対象になりつつあります。
AIを使ったサービスを開発している企業にとっては、自社が利用している検索APIやデータソースが、どのような条件でコンテンツを集めているのかを確認しておく必要が出てきそうです。契約やサービス規約の中で、権利処理の責任がどこにあるのかを見直しておくと、将来のリスクを減らせるでしょう。

The New York Times sues Brave web browser for AI scraping and bypassing paywalls
More publisher lawsuits over AI.



