0:00 0:00
記事
NVIDIA、AI Infra Summitで「トークン毎メガワット」を強調——Vera RubinとDSXで最大1.4倍の効率化
NVIDIA公式ブログによれば、AI Infra SummitでIan Buck氏がAIファクトリーの電力効率について講演し、Vera RubinとDSXプラットフォームによるトークン毎メガワットの改善や、Amazon・d-Matrix・Lambdaなどとの新たな協業を発表しました。
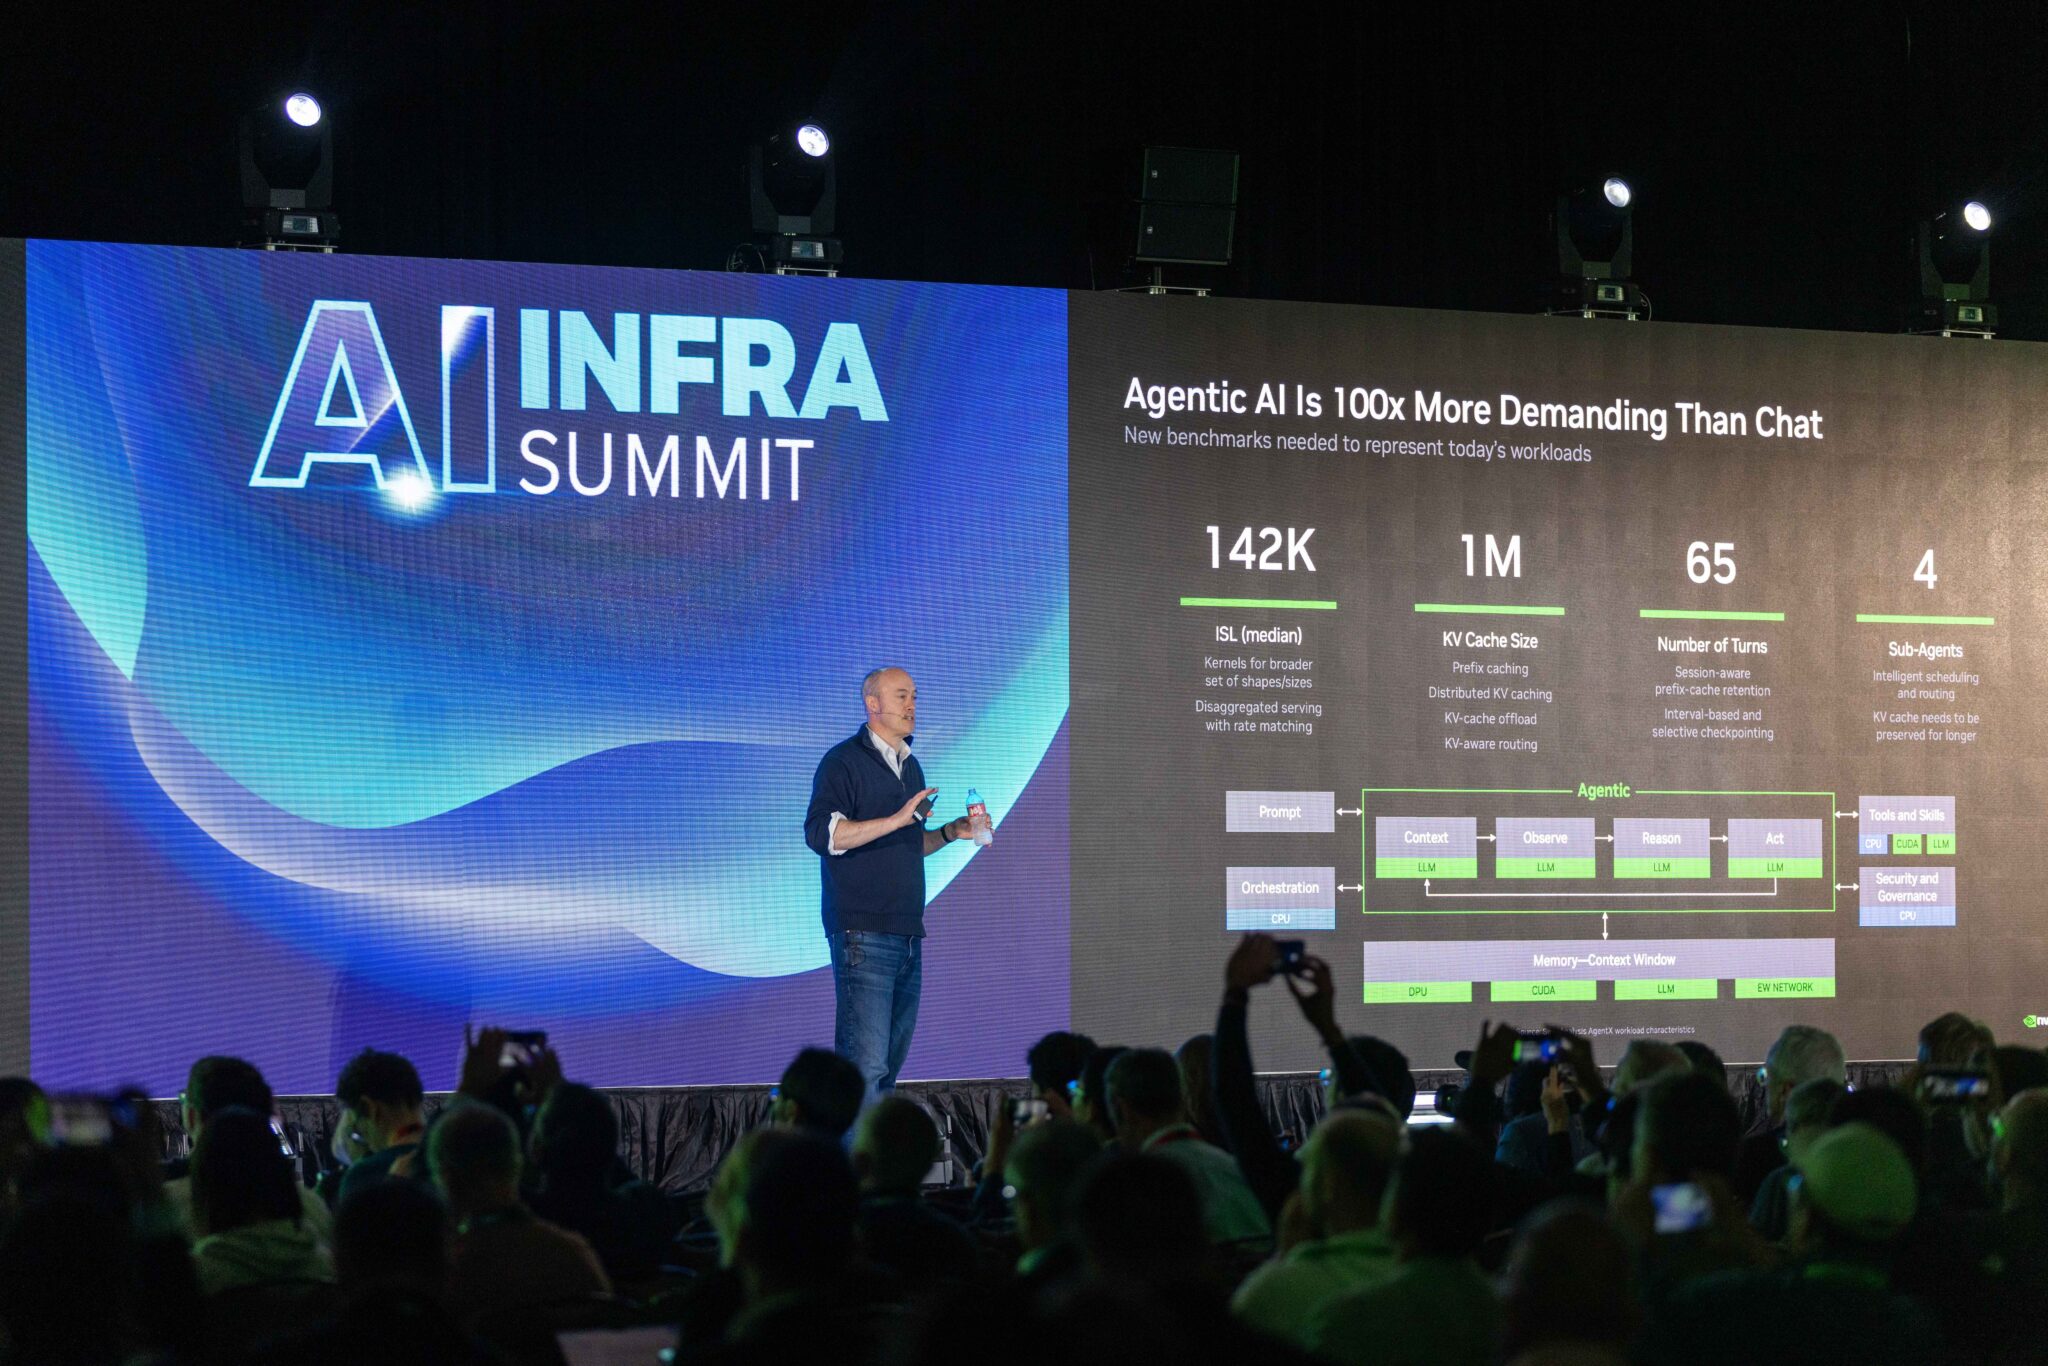
NVIDIA公式ブログによると、同社でハイパースケール・高性能コンピューティング担当バイスプレジデントを務めるIan Buck氏が、Santa Clara Convention Centerで開催されたAI Infra SummitでAIファクトリーの電力効率について講演しました。今年の来場者数は8,000人超と、昨年の3,500人から大幅に増加したといい、Buck氏はNVIDIAプラットフォーム全体にまたがる新たな協業や検証結果を紹介しました。
指標は「トークン毎メガワット」へ
Buck氏は、AIインフラを評価する指標がピーク性能から「検証済みのagentic tokens per megawatt(メガワットあたりのエージェント的トークン数)」へと急速に移りつつあると説明しました。AIファクトリーはもはやシリコンから電力網まで一体で設計する必要があるとし、NVIDIA DSX MaxLPSがファクトリー全体の電力最適化を通じて最大1.4倍のトークン毎メガワットを実現できると紹介しています。NVLinkによって大規模なアクセラレーテッドコンピューティングを単一の高性能システムとして統合できる点も、この効率化を支える要素として挙げられました。
主要パートナーとの新たな協業
講演ではNVIDIAプラットフォームを軸にした複数の新しい協業も明らかになりました。AmazonのAnnapurna Labsは、カスタムの高帯域幅メモリ技術「NVHBM」でNVIDIAと協業しています。半導体スタートアップのd-Matrixは、自社のRaptor XPUにNVLink Fusionプラットフォームを統合する取り組みを進めています。agentic AIが新しい種類のワークロードを生み出し、より高い性能・効率・スケールをAIインフラに求めている中、NVIDIAはVera Rubinシステム、Dynamo推論ソフトウェア、NeMoライブラリ、そしてNVLinkやSpectrum-X Ethernet、BlueField DPUを含むネットワーキング機器を組み合わせたフルスタックのAIファクトリー基盤でこれに応えるとしています。
画像引用元: NVIDIA Blog
Lambdaが実証したDSX MaxLPSの効果
AIクラウド事業者のLambdaは、NVIDIA Blackwellサーバー上でDSX MaxLPSを初めて検証し、その結果を公表しました。従来16台のフルパワーノードに割り当てていたのと同じ電力予算で19台のノードを稼働させることに成功し、クラスター全体のトークンスループットは毎秒約400万から500万へと24%向上、性能毎ワットも23%改善したといいます。次世代のNVIDIA Vera Rubin NVL72 AIファクトリーでは、適切な導入環境であればDSX MaxLPSにより同じメガワット予算内で最大40%多くのGPU容量を確保できる可能性があるとしています。
- Lambdaの検証結果: 同一電力予算で19ノード稼働(従来は16ノード)、トークンスループット24%向上、性能毎ワット23%改善
- 次世代Vera Rubin NVL72での見込み: 同一メガワット予算内で最大40%多くのGPU容量
- Vera Rubin×Groq 3 LPX: GB200 NVL72比で最大35倍のトークン毎メガワット(2兆パラメータ超のモデル・長文脈時)
グリッドの需給に応じた柔軟な電力制御
もう一つの発表が、AIファクトリーを電力網にとって柔軟なリソースとして機能させる取り組みです。Silicon Valley Powerが運営するフレキシブルロード連系プログラムでは、Emerald AIがNVIDIAと協業し、需要信号への自動的な負荷削減をデモンストレーションしました。AIワークロードの性能を守りながら、数百件に及ぶ需要信号に応答することに成功したといいます。Emerald AIは今後、電力網のリアルタイム信号や複数のエネルギー源に応じてAIファクトリーの消費電力を動的に調整するソフトウェア「DSX Flex」の「Conductor」を活用していく計画です。優先度の高いジョブは稼働を続けたまま、それ以外のジョブを一時的に停止・再開することで、電力網への負荷軽減に貢献できる仕組みになっています。
Vera RubinとGroq 3 LPXが引き出す電力あたりの性能
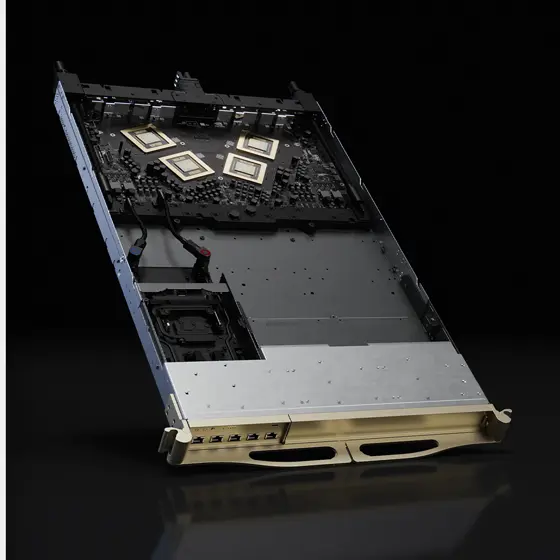
電力が制約となるAIファクトリーにおいて、メガワットあたりでより多くのトークンを引き出すことが最重要課題だとBuck氏は述べています。NVIDIAはVera Rubin NVL72を核に、システム・ネットワーキング・ソフトウェア・電力管理を一体で設計することでこれに対応しており、同一のサイト電力予算内で最大40%多くのGPU、新たな電力線を敷設することなく最大35%高いトークンスループットを実現できるとしています。ラック内部ではIntelligent Power Smoothingソフトウェアと拡張されたエネルギーバッファリングが短時間の電力スパイクを吸収し、余剰の電力余地を計算能力に転換します。推論に決定論的な超低遅延をもたらすGroq 3 LPXとの組み合わせにより、2兆パラメータを超えるモデルの長文脈推論で、GB200 NVL72比最大35倍のトークン毎メガワットを達成できるとしています。
電力調達がAIインフラ投資のボトルネックになりつつある中、インフラ担当者にとっては単純な演算性能だけでなく、メガワットあたりの実効トークン数を評価軸に加える必要が出てきそうです。
AI Infra Summit: NVIDIA Vera Rubin and DSX Platform Advancements Showcase Energy Efficiencies of Optimizing Tokens Per Watt for AI Factories
Ian Buck, vice president of hyperscale and high-performance computing at NVIDIA, Tuesday spoke on AI factory efficiency at the AI Infra Summit, the Santa Clara Convention Center event that has morphed into a Coachella of infrastructure tech. Before a packed audience — with more than 8,000 attendees this year, up from 3,500 last year — […]