0:00 0:00
記事
NVIDIA cuBLAS、FP64行列演算を最大5.5倍高速化——Ozaki-IIと2M法を整数Tensorコアで実行
NVIDIAはCUDA Toolkit 13.4.2のcuBLASで、倍精度の行列積を整数Tensorコア上で計算する新アルゴリズム「Ozaki-II」と「2M法」を導入しました。FP64と同等の精度を保ったまま、VR NVL72でDGEMMが5.5倍、GB200でZGEMMが5倍高速になります。
NVIDIAは2026年11月13日、CUDA Toolkit 13.4.2に含まれるcuBLASで、倍精度(FP64)の行列積を高速化する2つの新アルゴリズムを導入したと開発者向けブログで発表しました。FP64の精度を落とさずに、計算そのものを高速な整数Tensorコアで処理します。
分子化学や材料科学のシミュレーションでは、実行時間の大半を高精度の行列積(GEMM)が占めます。実数のFP64行列積はDGEMM、複素数ではZGEMMと呼ばれます。AI向けに低精度の演算性能が急速に伸びるなか、その性能を科学技術計算にも生かそうというのが今回の取り組みです。
倍精度の数値を整数に分解して計算する
cuBLASの新方式は、倍精度の数値を整数のかけらに分解し、それをGPUのTensorコアで掛け合わせてから、正確な結果に組み立て直すというものです。答えはFP64と同じ精度を保ちますが、計算自体はより高速なハードウェアで行われます。
この仕組みは、以前に導入された「Automatic Dynamic Precision(ADP)」というフレームワークを土台にしています。ADPは、精度を保つのに必要な整数の幅を実行時に自動で判断します。必要なビット数が既定値やユーザー指定の上限を超えた場合は、ネイティブのFP64命令を使う処理に自動で切り替わるため、本番環境でも数値精度を心配せずに使えるとしています。アプリケーションのコードを変更する必要もありません。
Ozaki-IとOzaki-IIの違い
今回の中心となるのが「Ozaki-II」です。従来の「Ozaki-I」との違いは、整数どうしの大きな掛け算をどう行うかにあります。
| 方式 | 計算の進め方 | GEMMの回数 |
|---|---|---|
| Ozaki-I | 整数を8ビットずつに分割し、三角形のパターンで掛け合わせる | 分割数の2乗に比例して増える |
| Ozaki-II | 中国剰余定理を使い、複数の小さな法ごとに1回ずつ整数GEMMを行う | 法の数に比例するだけで済む |
FP64と同等の精度を得る場合、Ozaki-IはOzaki-IIのおよそ2倍のTensorコアGEMMが必要になります。Ozaki-IIは素朴に実装すると作業用メモリが大きくなりますが、cuBLASではOzaki-I向けに導入したメモリ節約型のタイリングを適用し、使い終わった中間結果をすぐに捨てることで、メモリ使用量を抑えています。
Rubin世代では新形式TI16も活用
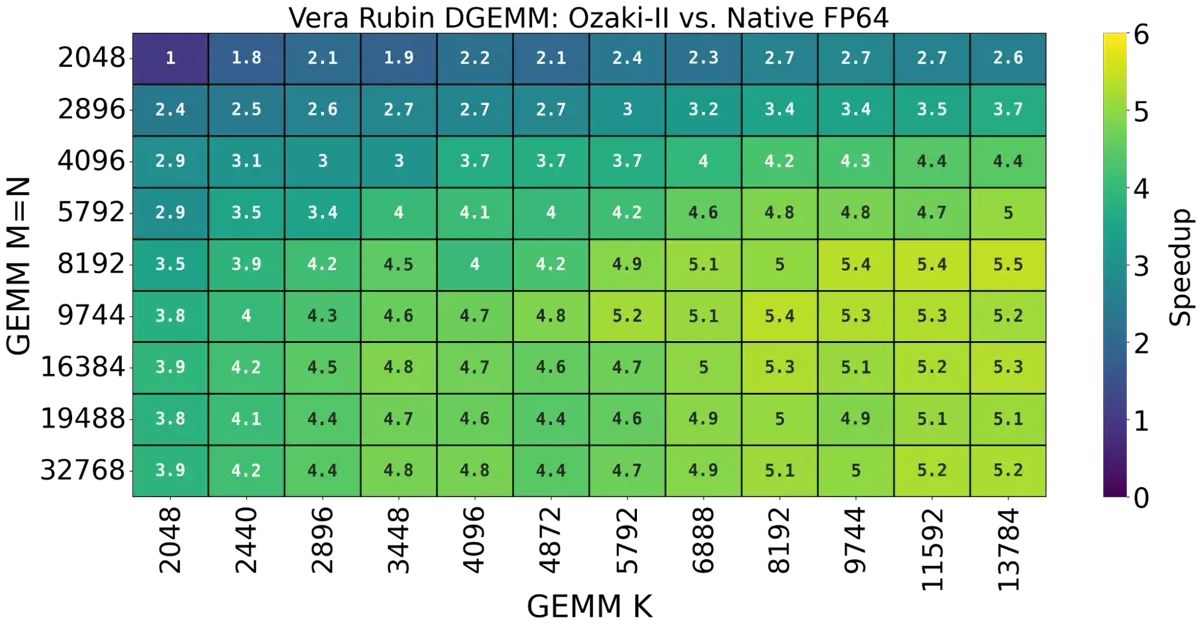
次世代GPUのNVIDIA Rubinでは、12ビット整数を符号と絶対値で表す新しい数値形式「TI16」が導入されます。cuBLAS 13.4はこのTI16と「tcgen05.mma」命令を使い、Ozaki-IとOzaki-IIの計算をさらに高速化します。
 画像引用元: NVIDIA Technical Blog
NVIDIAが公開した主な性能値は次のとおりです。
- DGEMM(Ozaki-II): ネイティブFP64比でVR NVL72は5.5倍、GB200は3.9倍。GB200ではOzaki-I比でも2倍
- ZGEMM(2M法): GB200でネイティブの複素FP64比5倍
- 最大演算性能: VR NVL72で175TFLOPS、GB200で147TFLOPS、RTX PRO 6000で37TFLOPS
RTX PRO 6000 Blackwell Server EditionはFP64ユニットに対する整数演算性能の比率が特に大きく、小さな行列でも10倍、最大で23倍の高速化を記録しています。
複素行列積は4回の掛け算から2回へ
複素数の行列積は通常、実数の行列積を4回組み合わせて計算します(4M法)。3回で済ませる「3M法」も知られていますが、浮動小数点では足し算や引き算の過程で誤差が積み重なりやすく、慎重に使われてきました。
Ozaki-IIでは足し算、引き算、掛け算のすべてが正確な整数演算になるため、どの方法を選んでも結果の精度は変わりません。この性質を生かした「2M法」では、複素行列積を実数の行列積2回で計算できます。その結果、ZGEMMのコストは従来の約4倍から約2倍に下がりました。cuBLASはCUDA Toolkit 13.4から、この2M法でZGEMMを高速化しています。
量子化学と材料科学で実アプリの効果を検証
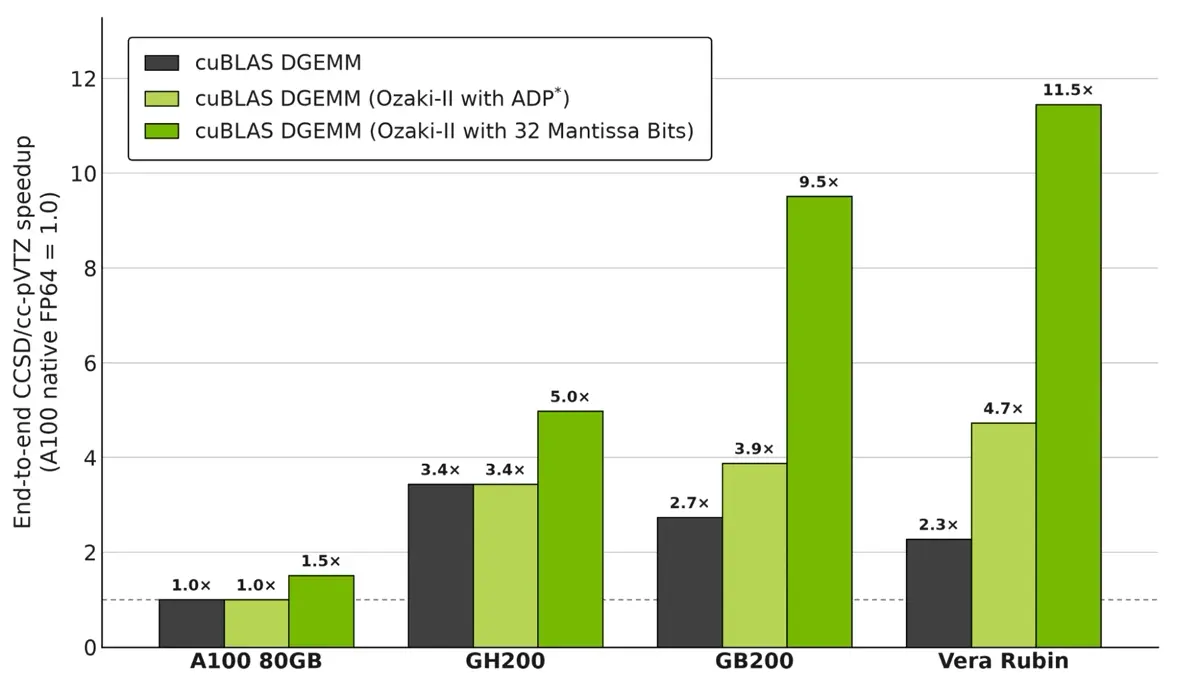
NVIDIAは、実際のアプリケーションでも速度と精度を確かめています。量子化学の「ゴールドスタンダード」の土台となるCCSD計算では、Ozaki-IIのDGEMMを使うことで、完全なFP64精度のままVR NVL72で2倍、GB200で1.4倍の高速化を達成しました。精度を32ビットの仮数に固定した混合精度モードでは、それぞれ5倍と3.5倍になります。
 画像引用元: NVIDIA Technical Blog
材料科学のBerkeleyGWでは、2M法とOzaki-IIを組み合わせたZGEMMにより、VR NVL72で6.6倍、GB200で3.9倍の高速化を確認しています。いずれのケースでも、結果はネイティブのFP64計算と同等の精度に収まっているとしています。
既存のHPCコードでも試しやすい
今回の改良は、アプリケーション側のコードを書き換えずにcuBLASを更新するだけで効果が出る点が大きな魅力です。新しいアルゴリズムを使うには、最新のCUDA Toolkitを導入するだけで済みます。
APIの詳細は、cuBLASドキュメントの浮動小数点エミュレーションの章にまとめられており、cublasSetEmulationStrategy()や仮数ビット数の手動指定なども解説されています。GitHubにはサンプルも用意されているので、DGEMMやZGEMMが処理時間の多くを占めるシミュレーションを動かしている人は、まず手元のワークロードで効果を測ってみるとよいでしょう。

Faster Scientific Simulations with New FP64 Algorithms in NVIDIA cuBLAS
Many scientific simulations, from molecular chemistry to materials science, spend the majority of their execution time computing high-precision dense general matrix multiplications (GEMM).



