0:00 0:00
記事
NVIDIA cuPhoton、ブラックホール観測の相関処理をGPU化——10TBを70秒、CPU比460倍
NVIDIAは、イベント・ホライズン・テレスコープ(EHT)の電波干渉計データをGPUで相関処理する「cuPhoton.xBeam」の使い方を公開しました。Vera Rubin NVL72の64基のGPUで10TBのデータを70秒で処理し、x86 CPU比で約460倍の高速化を達成したとしています。
NVIDIAは2026年11月13日、科学画像処理ツールキット「cuPhoton」に含まれる電波干渉計向けの相関器「xBeam」の解説記事を、公式の開発者ブログで公開しました。ブラックホールの撮影で知られるイベント・ホライズン・テレスコープ(EHT)の観測データを、GPUで高速に処理するためのものです。
Vera Rubin NVL72の64基のGPUとGPUDirect Storageを使い、10TBのデータセットを70秒で処理しました。x86 CPUで3万1992秒(約8.9時間)かかっていた処理で、約460倍の高速化になります。
地球サイズの望遠鏡が生む膨大なデータ
ブラックホールは非常に遠く、空の上ではごく小さくしか見えません。たとえばM87*のリングの見かけの大きさは、わずか42マイクロ秒角です。ブラックホール自体は光を出さないため、望遠鏡が捉えるのは事象の地平線の外側で渦巻く超高温ガスからの電波です。
EHTはハワイ、チリ、スペイン、メキシコ、南極など13の電波観測所を超長基線電波干渉法(VLBI)で結び、地球サイズの仮想的な望遠鏡として使っています。各局は2つの偏波で、1局あたり最大64Gbpsの電圧データを記録します。観測全体ではペタバイト級のデータになり、これを局のペアごとに突き合わせる「相関処理」が最初の大きな計算になります。
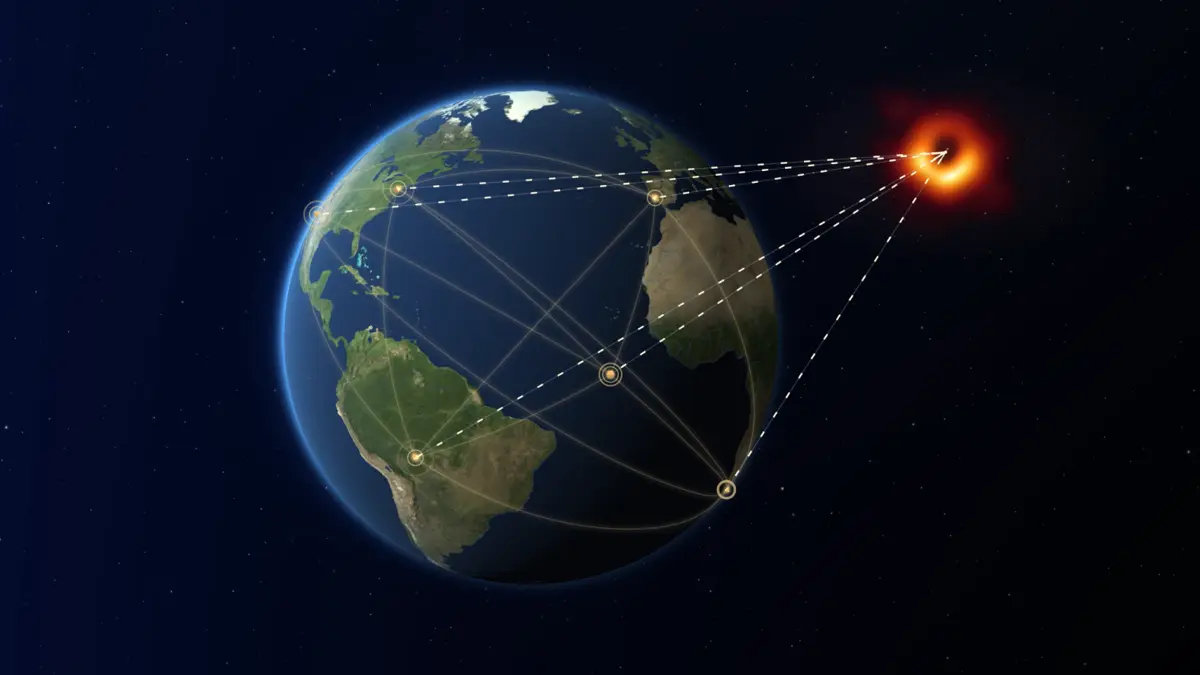 画像引用元: NVIDIA Technical Blog
xBeamが担うFX相関の5ステップ
xBeamは、CPUベースのオープンソース相関器として広く使われているDiFXと同じ「FX型」の相関器です。各局の電圧をFFTで周波数チャンネルに分け(F)、局と偏波のペアごとに掛け合わせる(X)処理をGPUで実行します。処理は次の5段階で進みます。
- 取り込み: VDIF形式のフレームを読み、正しい時刻に配置する。
.vdixというインデックスファイルを作り、データをコピーせずに各フレームの位置を記録する - 遅延とフリンジの補正: ジョブで与えた遅延モデルに従って各局のサンプルをずらし、地球の自転による位相のずれを取り除く
- チャンネル化: 各局の電圧ストリームにFFTをかけて周波数チャンネルに分割する
- 乗算と積算: 局のペアごとにスペクトルを掛け合わせ、積分時間にわたって足し合わせる
- 書き出し: 結果をDiFXのSWIN形式か、xBeam独自のxbeam-v1形式で保存する
なお、xBeamは局の位置から遅延を計算するわけではなく、ジョブファイルに書かれた遅延をそのまま使います。キャリブレーションや画像の再構成も対象外です。
64基のGPUで約460倍、読み込みは毎秒170GB
xBeamは観測時間をGPUごとに分割してスケールします。1台のノードでは--devicesオプションで複数のGPUを同時に起動でき、複数ノードにまたがる場合は--shard-countと--shard-indexで時間を分割したうえで、merge-shardsで部分的な出力をひとつにまとめます。マージ時には、すべてのシャードが同じジョブから作られ、時間範囲を漏れなくカバーしているかも確認されます。
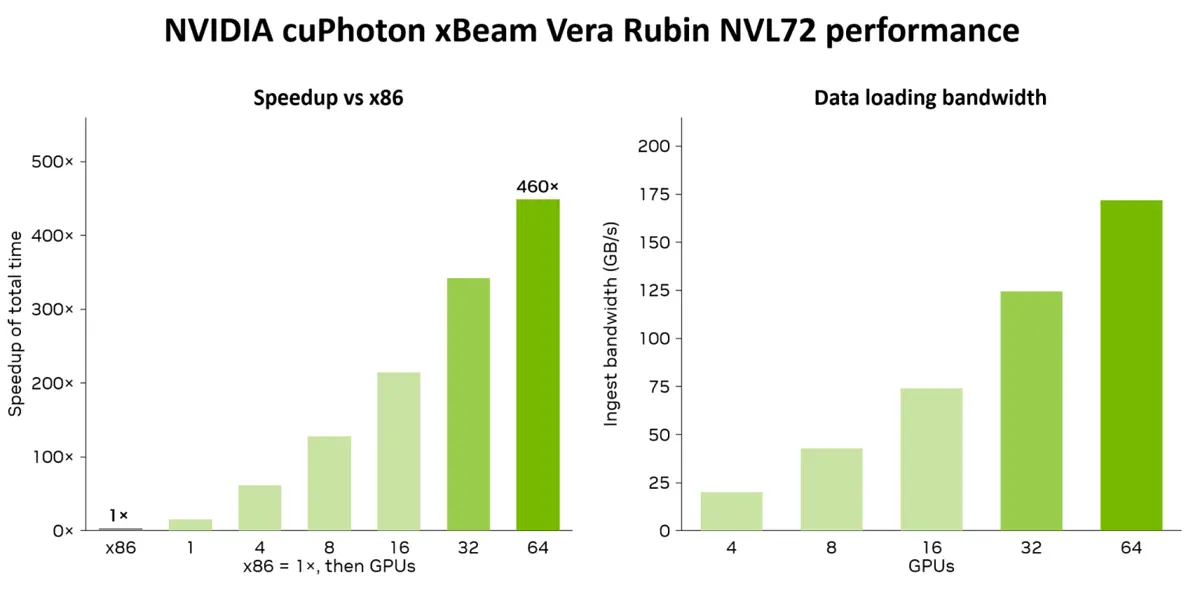 画像引用元: NVIDIA Technical Blog
計測は読み込み、前処理、相関処理を合わせた総処理時間で行われています。GPUDirect Storageを使った読み込み帯域は、GPU4基で毎秒20GB、64基で毎秒170GBまで伸びました。テストした範囲では、GPUを増やすほど速度が向上し続けたとしています。
コマンドラインとPythonの両方から使える
xBeamはcuPhoton v0.1.3に含まれており、正規化されたJSONのジョブファイルか、DiFXの.inputファイルを入力として受け付けます。サンプルの観測データとジョブファイルはGitHubのリポジトリで公開されています。
使い方は、まずinspect-vdifでヘッダーを確認し、build-vdif-sidecarでインデックスを作成してから、correlateで相関処理を実行する流れです。同じジョブはPythonからも呼び出せて、load_jobでジョブを読み込み、correlateがビジビリティを1件ずつ返します。GPUDirect Storageがない環境では、POSIXのI/Oに切り替えて動かすこともできます。
開発にはハーバード・スミソニアン天体物理学センターとMITヘイスタック観測所が協力しています。
AIエージェントによる観測パイプラインの自動化も視野に
NVIDIAは、AIエージェントがVDIFのメタデータを解析してジョブファイルを生成し、GPUクラスターでxBeamを起動して実行を監視するといった、パイプライン全体の自動化にも言及しています。ただし、今回のベンチマークはあくまでGPUによる高速化を示したもので、エージェントによる制御は今後の応用例という位置づけです。
8時間以上かかっていた処理が1分強で終わるようになれば、観測データを何度も処理し直して条件を変えながら検証する、といった使い方が現実的になります。観測所を増やして画質を上げる次世代EHT(ngEHT)ではデータ量がさらに増えるため、こうした高速化の重要性は高まりそうです。電波天文学に限らず、大容量の時系列データを扱う研究やHPCに関わる人にとっても、GPUDirect Storageと組み合わせたスケーリングの実例として参考になるでしょう。

Run GPU-Powered Black Hole Interferometry with NVIDIA cuPhoton
Imaging black holes is challenging because they are distant and appear tiny in the sky—for example, M87*’s observed ring spans just 42 microarcseconds. The black hole itself emits no light…



