0:00 0:00
記事
NVIDIA、7530億パラメーターのGLM-5.3を2台のDGX Stationで動かす手順を公開——最大607.8トークン/秒
NVIDIAは、1台のGB300に収まらない約464GBのGLM-5.3 NVFP4を、ConnectX-8でつないだ2台のDGX Stationとテンソル並列で動かすチュートリアルを公開しました。vLLMで1つのOpenAI互換APIとして提供し、同時16リクエストで最大607.8トークン/秒を記録しています。
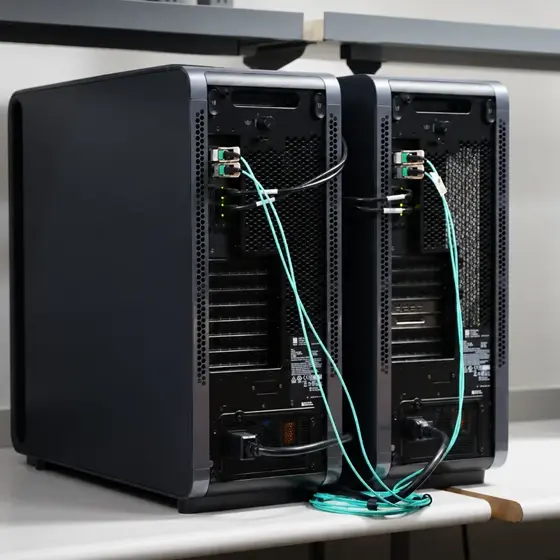
NVIDIAは2026年11月13日、2台の「DGX Station」を連携させ、大規模言語モデル「GLM-5.3」をローカルで動かす手順を開発者向けブログで公開しました。推論エンジンにはvLLMを使い、2台をまたいだモデルを1つのOpenAI互換APIとして提供します。
最先端クラスのモデルをローカルで動かすには、すべての重みをGPUメモリに載せる必要があります。しかし最大級のモデルは、もはや1台のマシンには収まりません。今回のチュートリアルは、ConnectX-8のRDMAで2台をつなぎ、テンソル並列でモデルの重みと計算を両方のGPUに分割することで、この問題を解決しています。
画像引用元: NVIDIA Technical Blog
464GBのモデルは1台に収まらない
対象となる「GLM-5.3 NVFP4」は、Z.aiが開発したMoE(Mixture of Experts)モデルを、NVIDIAが量子化したものです。総パラメーター数は7530億で、1トークンあたりに使われるのは400億パラメーターです。
MoEは一部のエキスパートだけを動かすため計算量は抑えられますが、トークンごとに別のエキスパートへ振り分けられる可能性があるので、すべての重みを常に使える状態にしておく必要があります。チェックポイントの大きさは約464GBで、1基のGB300 GPUが持つ252GBのHBM3eを超えてしまいます。そこで2台のDGX Stationを使い、CPUへの重みの退避を無効にしたまま、すべての重みをGPUメモリに載せています。
2台で1つのサービスにする構成
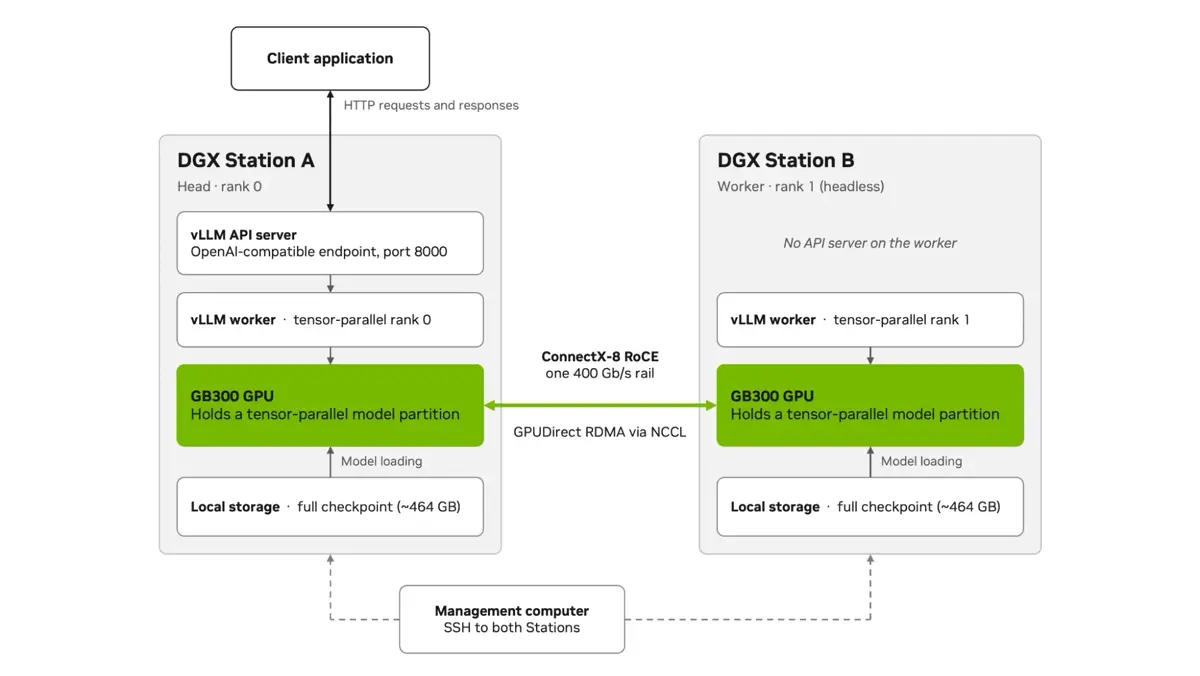
構成は、Station A(ランク0)がAPIを提供し、Station B(ランク1)がワーカーだけを動かす形です。テンソル並列(TP=2)でモデルのテンソルを2基のGB300に分け、すべてのリクエストを両方のStationで計算します。どちらのGPUも完全なコピーを持たず、1台だけでは応答できません。トークンを1つ生成するたびに、両者が400Gb/sのRoCE接続で部分的な計算結果をやり取りします。
 画像引用元: NVIDIA Technical Blog
モデルを読み込むと、各GB300のメモリ使用量は約231GiBになります。残りのメモリは、処理中のリクエストの文脈を保持するKVキャッシュに使われます。
速度を引き出す3つの設定
起動スクリプトでは、スループットを高めるための設定が3つ有効になっています。
- マルチトークン予測(MTP): 投機的デコーディングの一種で、モデルのMTP層が1ステップで4トークンの下書きを作り、vLLMが本体のモデルで確認してから採用する。下書きの採用率はプロンプトによって変わる
- FP8のKVキャッシュ: 16ビットで保持する場合に比べてキャッシュのメモリを半分にし、より多くのトークンを扱えるようにする
- プレフィックスキャッシュ: 一度処理したプロンプトの先頭部分を再計算しないようにする
コンテキスト長の上限は98,304トークン、GPUメモリの割り当ては93%に設定されています。NVIDIAは、APIを0.0.0.0で公開すると認証のないエンドポイントが管理用を含むすべてのインターフェースにさらされるため、ファイアウォールで接続元を絞り、広く使う前に認証とTLSを追加するよう注意を促しています。
同時リクエスト数で変わる速度
ベンチマークには、NVIDIAの推論ベンチマークツール「AIPerf」と、SPEED-Benchのコーディング用データセットを使っています。出力の上限は8,192トークンで、推論過程のトークンも数に含まれます。
| 同時リクエスト数 | 全体のスループット(トークン/秒) | 平均レイテンシー(秒) | 最初のトークンまで(ミリ秒) | トークン間隔(ミリ秒) |
|---|---|---|---|---|
| 1 | 107.4 | 49.84 | 479.75 | 8.78 |
| 8 | 386.0 | 114.17 | 433.79 | 19.01 |
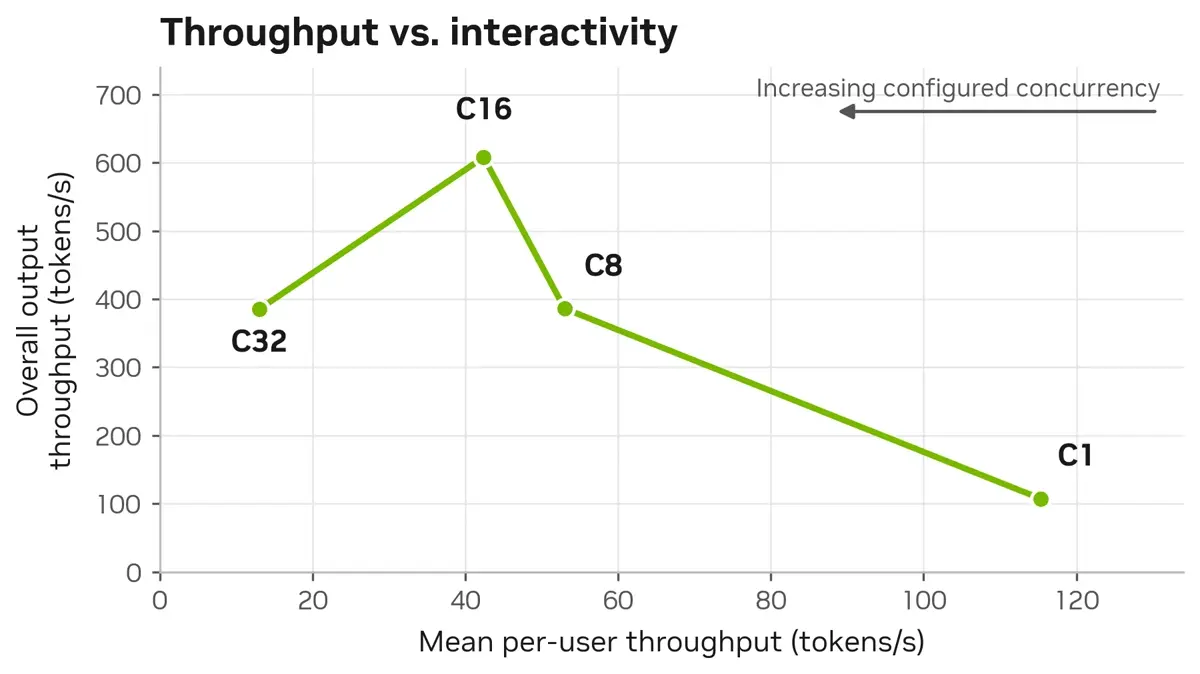
| 16 | 607.8 | 136.46 | 482.90 | 23.77 |
| 32 | 385.0 | 453.54 | 899.36 | 77.90 |
全体のスループットは同時16リクエストで607.8トークン/秒に達しますが、32に増やすと385.0トークン/秒まで落ち、平均レイテンシーは453.5秒に延びました。利用者1人あたりの速度も、同時1リクエストの115.3トークン/秒から、32では13.0トークン/秒まで下がっています。
 画像引用元: NVIDIA Technical Blog
手元で巨大モデルを動かす選択肢
NVIDIAは、7530億パラメーターのモデルを机の上の2台で動かせることで、機密データや社外に出せないデータでの推論、エージェントのローカルでの試作、トークン課金を気にしないプロンプトの調整といった使い方ができると説明しています。2台の接続には「Connect Two DGX Stations」のプレイブックを使い、事前にGPUメモリ間のRDMAテストまで済ませておくことが前提です。
ベンチマークの結果からは、同時リクエストを増やせば増やすほど速くなるわけではないことが読み取れます。チームで共有するエンドポイントとして使うなら、自分たちのプロンプトでAIPerfを回し直し、全体の処理量と1人あたりの待ち時間のバランスがとれる同時実行数を探すのが現実的な進め方になるでしょう。

When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM
Running a frontier-scale model locally means keeping all its weights in GPU memory; the largest models no longer fit on one machine. Two NVIDIA DGX Stations connected over ConnectX-8 RDMA serve one…



