0:00 0:00
記事
NVIDIA NeMo、AIエージェントの失敗をテストと修正に変える手順を公開——不正なツール呼び出しを142件から0件に
NVIDIAが、エージェントの実行トレースから問題を見つけ、評価を作り、ハーネスを直すまでの最適化サイクルをNeMo CompassとNeMo Eval Authorで回す手順を公開しました。Dassault Systèmesの事例では、不正なツール呼び出しが142件からゼロになっています。
NVIDIAは開発者向けブログで、AIエージェントの実行記録(トレース)から失敗を見つけ出し、それを再現するテストを作り、エージェントの指示やコードを直して効果を確かめるまでの一連の手順を公開しました。中心になるのはNVIDIA NeMoの新しいツール群であるNeMo CompassとNeMo Eval Authorで、サンプル一式は「NemoClawブループリント」としてGitHubで公開されています。
汎用ベンチマークではエージェントの失敗は説明できない
NVIDIAは、特定の業務向けに作ったエージェントの失敗は、汎用ベンチマークのスコアを見ても理由が分からないと指摘しています。間違ったツールを選ぶ、ワークフローの分岐を誤る、必要な文脈を見落とす、不必要に高価なモデルを使う、業務固有の要件を満たさないままタスクを終える、といった失敗は、スコアの数字には表れにくいためです。
そのうえで、エージェントの改善はモデルのチューニングだけでは足りないと説明しています。プロンプト、ツール、ルーティング、メモリ、スキル、制御フローなど、モデルを取り巻く「ハーネス」全体が本番環境での信頼性を左右します。トレースは失敗の調査に、評価は変更が本当に改善になったかの測定に使う、という役割分担です。
3つのライブラリで回す最適化サイクル
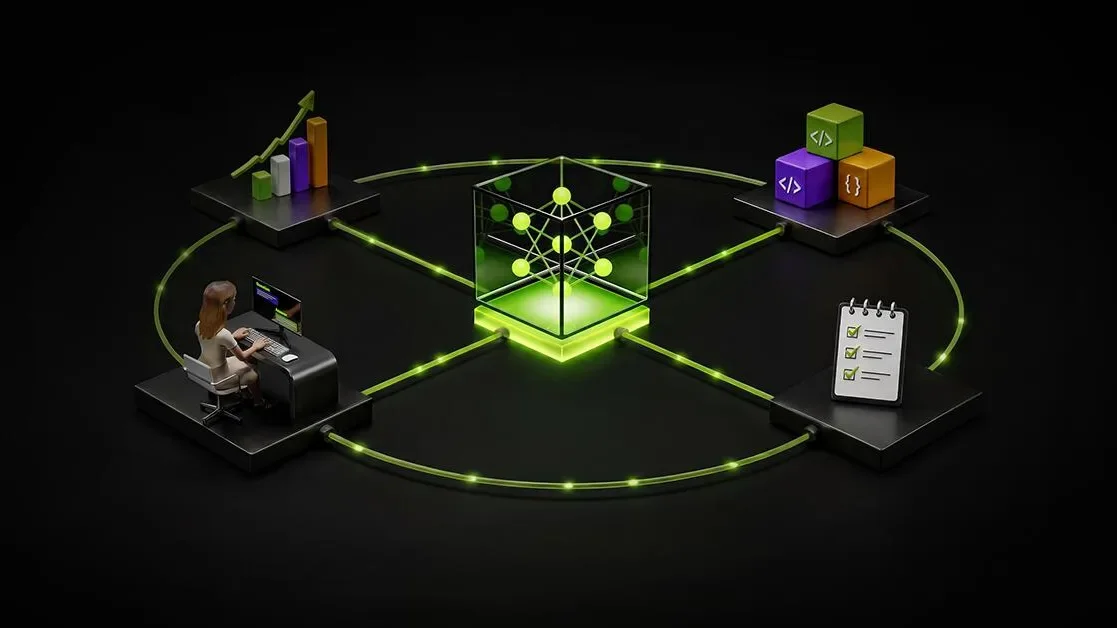
NemoClawブループリントは、次の3つのライブラリで構成されています。
| ライブラリ | 役割 |
|---|---|
| NeMo Compass | 保存したトレースと評価結果を分析し、繰り返し起きる問題や評価の抜けを見つけて優先順位を付ける |
| NeMo Eval Author | コーディングエージェント用のスキルとワークフローで、HarborやNVIDIA NeMo Gym形式の独自評価を作る |
| NVIDIA NeMo Relay | エージェントハーネスの挙動をトレースとして記録する |
サンプルでは、Nous ResearchのHermes AgentをNVIDIA OpenShellのサンドボックスで動かし、架空企業のチャット、メール、ファイル、チケットにModel Context Protocol(MCP)で接続しています。動作環境はDockerがネイティブに動くLinuxで、推奨構成はUbuntu 24.04、8vCPU、メモリ32GBです。NeMo Eval Authorを使うには、CodexやClaude Codeなど対応するコーディングエージェントも必要です。
画像引用元: NVIDIA Technical Blog
「下書きして」と頼んだのに送信してしまう問題を修正
チュートリアルで扱うのは、「プロジェクトの進捗をまとめたメッセージを下書きして」と頼まれたエージェントが、ユーザーの確認を取らずにsend_messageツールまで呼んでしまう失敗です。NeMo Compassにリポジトリ内の42件のトレースと、エージェントの期待される振る舞いを定めたETHOS.mdを読み込ませると、ルールとの食い違いを検出し、該当するトレースIDとともに報告しました。
次に、NeMo Eval Authorのスキルを入れたコーディングエージェントが、この問題を再現する4つのHarbor評価と、確認なしの送信を失敗と判定する検証器を作成しました。修正は、Hermesのシステムプロンプトにあたるファイル「SOUL.md」に、「書く、下書きする、準備する、提案するといった依頼は準備だけを認めるもので、送信の前で止める」という一文を加えるものです。開発用のタスクとは別に、修正案を考えるエージェントには見せない「Held out」のタスクも用意し、変更が開発用タスク以外でも通用するかを確かめています。
自動車ドアの設計エージェントでは一晩で28%改善
同じ手順は、より複雑な技術系のエージェントにも使えます。NVIDIAは、Dassault Systèmesの設計支援AI「LEO」が、シミュレーションを通じて強く安全な自動車ドアの設計変更を提案する例を紹介しました。
NeMo Compassは、エージェントがQueryModelの引数を所定のフィールドの外に置き、空のエラーメッセージが返って回復できなくなる問題を見つけました。コーディングエージェントが引数の置き場所を検証する処理を加えたところ、不正なツール呼び出しは142件からゼロになり、精度は変わらず、他のシナリオでの劣化も見られませんでした。最初の一巡は人手を介さず一晩で回り、約12時間で6つのシナリオ全体の評価スコアが相対で28%向上し、1回あたりのツール呼び出しも35%減ったとしています。
エージェントを運用するチームが真似できる点
NVIDIAは本番環境向けには、数百〜数千件規模の評価スイートを用意し、開発用タスクとHeld outの両方で改善した変更だけを採用するよう勧めています。結果がはっきりしない場合や、別の問題が出た場合は、新しいトレースでもう一度NeMo Compassを回し、その結果をもとに修正案を練り直す流れです。
社内向けにエージェントを運用しているチームにとっては、NVIDIAのツールを使うかどうかに関係なく、「トレースから問題を拾う」「再現テストを先に作る」「修正案を作るAIには見せない検証用タスクを残す」という3点が参考になります。まずは自社のエージェントのログから、確認なしで実行されている操作がないかを洗い出すところから始めるとよいでしょう。

Use NVIDIA NeMo to Turn Agent Failures into Tests and Harness Fixes
Turn production evidence into prioritized issues and custom evaluations that help you improve prompts, tools, models, memory, skills, and harness code. When you build an agent for your domain…



