0:00 0:00
記事
NVIDIAとElith、日本の金融向け合成ペルソナ900万件を公開——「Nemotron-Personas-Finance-Japan」は商用利用可
ElithとNVIDIAは、日本の公的統計と家計・金融リテラシーのデータを組み合わせた合成ペルソナデータセット「Nemotron-Personas-Finance-Japan」をHugging Faceで公開しました。900万件のペルソナを自然な日本語で収録し、CC BY 4.0で商用利用できます。実在の顧客データを使わずに金融AIを開発・評価できるのが特徴です。
NVIDIAは2026年11月9日、Hugging Faceのブログで、日本の金融分野に特化した合成ペルソナデータセット「Nemotron-Personas-Finance-Japan」を公開しました。日本のAI企業Elithとの共同開発で、既存の「Nemotron-Personas-Japan」を金融向けに拡張したものです。日本の公的統計と家計・金融リテラシーのデータを組み合わせた、100万レコード規模のオープンなペルソナデータセットとしては初めてのものだとしています。
金融AI開発を阻む「実データの壁」
金融業界では、厳しいプライバシー規制やコンプライアンス要件があり、実際の顧客データをAI開発に使うことには大きな制約があります。一方で、金融分野のエージェントAIを作るには、年齢や家族構成、資産状況などを反映した多様で現実的なシナリオが欠かせません。
今回のデータセットは、実データを使うリスクを避けながら、こうした条件を再現するために作られました。損害保険ジャパンや東京海上ホールディングス、福岡銀行、みずほフィナンシャルグループ、明治安田生命、金融データ活用推進協会(FDUA)といった国内の金融機関や業界団体の知見とフィードバックを取り入れて設計されています。
データセットの中身
公開されたデータセットの主な仕様は次のとおりです。
| 項目 | 内容 |
|---|---|
| ペルソナ数 | 900万件(100万レコード×各9ペルソナ) |
| フィールド数 | 1レコードあたり50(ペルソナ9、属性11、統計に基づく文脈30) |
| トークン数 | 約15億(うちペルソナ部分が約7億5000万) |
| 固有の氏名 | 約95万種類 |
| 職業カテゴリ | 1600以上 |
| ライセンス | CC BY 4.0(商用・非商用ともに利用可) |
ペルソナは職業やスポーツ、芸術、旅行、料理に加え、金融、金融行動、お金に関する悩みといった種類に分かれています。従来のNemotron-Personas-Japanと比べるとペルソナ数は50%多く、フィールド数も22から50へと大きく増えました。
統計に基づく生成パイプライン
データの生成には、NVIDIAの合成データ生成フレームワーク「NeMo Data Designer」が使われています。統計的な裏付けのある属性を生成する確率的グラフィカルモデルのフレームワーク「NeMo SDG-PGMs」と、日本語の文章生成を担うGemmaの「gemma-4-31B-it」を組み合わせた構成です。
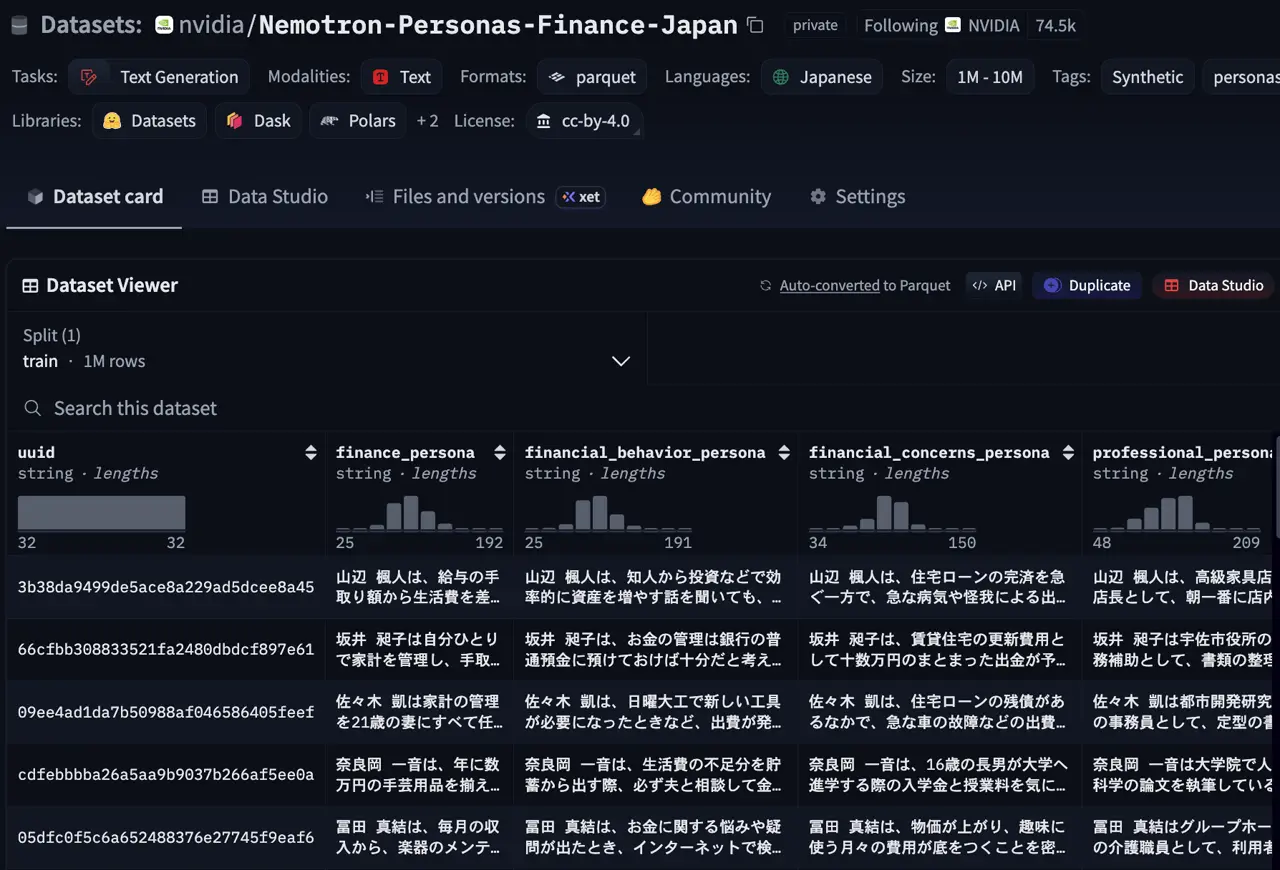 画像引用元: Hugging Face Blog
日本の実情に合わせた工夫も施されています。国の統計では大まかにまとめられがちな学歴を細かく分けたほか、経営者や専門職などの職業カテゴリを追加しました。学生や退職者、失業中といった統計に表れにくいライフステージもモデル化し、個人の収入だけでなく世帯の金融資産や実物資産、ネットやスマートフォンの利用状況、金融リテラシーまで盛り込んでいます。
なお、Nemotron-Personasのコレクションは、ユーザーシミュレーションのフレームワークとそのまま組み合わせられるように設計されています。現実の分布に沿った多様な顧客像を使って、すぐにシミュレーションを走らせられる点も特徴です。
実在の個人を含まない設計
すべてのペルソナは完全な合成データで、実在の個人は含まれていません。人口構成や家計は公的統計と公開調査データの分布に従い、氏名も日本の実際の命名パターンに沿って作られていますが、特定の人物の記録をもとにしたものではないとしています。
想定する利用者は、まず日本の銀行や保険会社、そしてそれらを支援するスタートアップやシステムインテグレーターです。カスタマーサービス用のエージェント開発、営業トークやマーケティング施策の評価、ユーザーシミュレーションフレームワーク「NeMo User Sim」でのシミュレーション、顧客向けAIのレッドチーミングなどに使えます。都市部と地方、年齢層、学歴、経済状況の違いによってAIの振る舞いに偏りがないかを確かめるバイアステストにも役立つとしています。
日本の金融AI開発者への影響
日本語の金融AIを作るうえでは、英語圏のデータセットを翻訳しても、日本の税制や家計の実態、金融商品への意識までは再現できません。日本の公的統計に基づき、国内の金融機関の意見を反映したデータが商用ライセンスで使えることは、PoCの段階で止まりがちな金融AIの開発を前に進める材料になります。
社内の顧客データを使った検証に法務やコンプライアンスの承認が必要で時間がかかっているチームは、まずこのデータセットで評価用の会話データを作り、エージェントの応答品質を確かめるところから始めるとよいでしょう。高齢者や投資経験の少ない層への説明が適切かどうかといった観点で、自社のチャットボットを点検する際のテストケース作りにも活用できます。

Nemotron-Personas-Finance-Japan: A Synthetic Dataset Capturing Japan's Demographics and Financial Context
A Blog post by NVIDIA on Hugging Face



