0:00 0:00
記事
NVIDIA、エージェント安全基盤「OpenShell」をCNCFへ寄贈——Kubernetes向けの新OSS3種も公開
NVIDIAはKubeConで、AIエージェントを統制するランタイム「OpenShell」をCNCFに寄贈すると発表しました。Google主導のAgent Substrateへの参加に加え、NVIDIA Kubernetes Engine、Kubernetes Recipes、Snapshotの3つのオープンソースも公開しています。
NVIDIAは2026年11月10日、クラウドネイティブ分野のカンファレンス「KubeCon + CloudNativeCon」に合わせて、オープンソースへの取り組みを広げると発表しました。中心となるのは、自律型AIエージェントを安全に動かすためのランタイム「OpenShell」をCloud Native Computing Foundation(CNCF)へ寄贈することです。あわせて、GPUを使うKubernetes環境向けの新しいオープンソースも3つ公開しました。
OpenShellがCNCFのSandboxプロジェクトに
OpenShellは、AIエージェントにできることを組織が管理するためのランタイムです。エージェントがツールを使ったり、推論サービスにアクセスしたり、処理を実行したりする場面に決定論的な制御をかけ、あらかじめ決めたポリシーを守らせます。自社の計算資源や推論プロバイダー、認証情報の保管庫、監視ツールをつなげられる拡張性も備えています。
公開から1年足らずで数百の組織が導入し、数万件のコントリビューションが寄せられたとしています。今後はCNCFのSandboxプロジェクトとして、製品に組み込む企業や世界中のセキュリティ専門家が参加する形で運営されます。Linux FoundationのJim Zemlin CEOは、エージェントに安全な実行環境を与えることがクラウドネイティブの新しい課題だとコメントしました。
Google主導のAgent Substrateにも参加
エージェントを統制するだけでなく、大規模に動かす仕組みも必要です。NVIDIAは、Googleが始めたCNCF Sandboxプロジェクト「Agent Substrate」に参加し、推論基盤のNVIDIA Dynamoや、クラスタの資源を割り当てるKAI Schedulerと連携できるようにします。
Agent Substrateは、タスクとタスクの間でエージェントの実行環境を保ったまま、待機中は計算資源を解放する仕組みです。共有のプールで環境の一時停止と再開を繰り返すことで、セッションごとに専用の計算資源を確保し続ける必要がなくなります。NVIDIAとGoogleはOpenShellとAgent Substrateの統合も進めており、クラウドとオンプレミスをまたいでエージェントを管理できるようにする計画です。
新たに公開された3つのオープンソース
もう一つの柱が、AIファクトリー向け基盤「NVIDIA DSX AI Factory Platform」の新しい構成要素です。
| 名称 | 役割 | 状況 |
|---|---|---|
| NVIDIA Kubernetes Engine(NVKE) | GPU基盤上でマネージドKubernetesを提供するための部品 | パブリックプレビュー |
| NVIDIA Kubernetes Recipes(NVKR) | クラスタのライフサイクル管理を自動化し、署名済みでバージョン固定のイメージを提供 | パブリックプレビュー |
| NVIDIA Snapshot | チェックポイントからレプリカを数秒で復元 | オープンソースで公開 |
NVKEとNVKRについては、Mirantis、Netris、OpenNebula Systems、Rafay、Spectro Cloud、vClusterに加え、FirmusとSK Telecomも、自社のサービスに機能を取り込む計画をNVIDIAと共有しているということです。
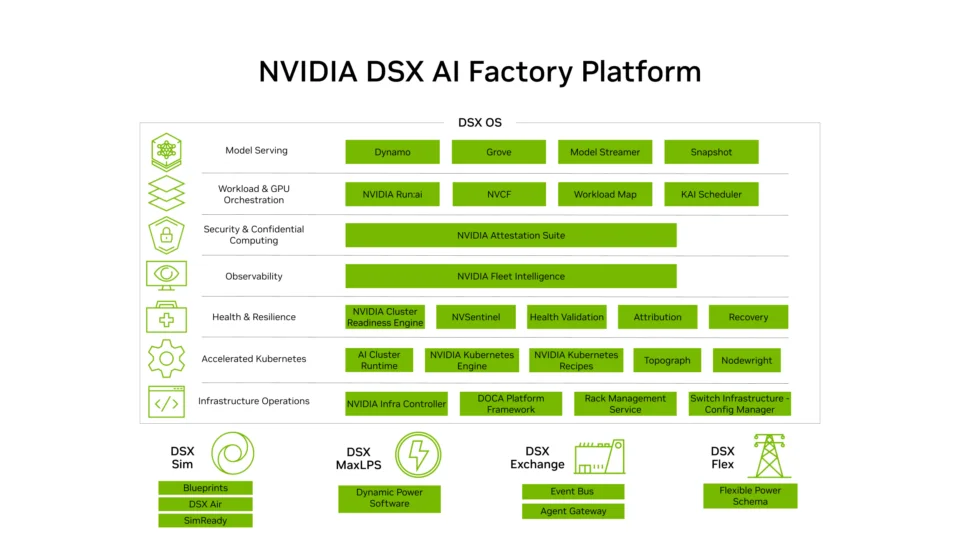 画像引用元: NVIDIA Blog
Snapshotで推論の立ち上げが数十秒に
なかでも効果がわかりやすいのがSnapshotです。推論の処理能力を増やすとき、モデルの読み込みやウォームアップに時間がかかり、スケールや障害からの復旧が遅れるという問題がありました。Snapshotはチェックポイントを取ったレプリカを、モデルの再読み込みなしで数秒のうちに復元します。
設計パートナーの検証結果も公表されています。Crusoeは自社クラウドでGLM-5.3を動かし、ワークロードが使える状態になるまでの時間を約8分から31秒に短縮しました。Saturn CloudはゼロからのスケールでvLLMの起動時間を測り、2〜8.5分かかっていた処理が6〜34秒に縮んだとしています。どちらもNVIDIA HGX B300での結果です。
エージェント運用のインフラ担当者への影響
社内でAIエージェントを動かし始めているチームにとって、OpenShellがベンダー中立の団体へ移ることは安心材料になります。特定企業の都合で方針が変わりにくくなり、ほかのプロジェクトとの連携も進めやすくなるためです。エージェントに与える権限の管理方法をまだ決めていないなら、候補の一つとして検討する価値があります。
GPUクラスタを運用する立場では、Snapshotの効果が大きそうです。夜間に推論のレプリカを減らしても、朝の需要増加に数十秒で追いつけるなら、待機させておくGPUを減らせます。まずは現在のコールドスタートにかかる時間を計測し、短縮できた場合のコストを試算してみるとよいでしょう。
NVIDIA Expands Open Source Commitment With OpenShell Donation and New AI Infrastructure
At KubeCon, NVIDIA is putting tools to secure agents and run AI on Kubernetes in the hands of the cloud-native community.



