0:00 0:00
記事
NVIDIA、強化学習の重み転送を最大5.7倍速くする「Reshard」を公開——兆パラメーター級モデルの後学習を高速化
NVIDIAは、強化学習の後学習で学習用GPUから推論用GPUへ重みを移す「refit」を高速化する新しい集団通信「Reshard」を発表しました。オープンソースのNCCL M2N Reshardとして提供し、NeMo RLでの計測では従来方式より2.7〜5.7倍速くなったとしています。
NVIDIAは2026年11月6日、強化学習(RL)による後学習で発生する重みの転送処理「refit」を高速化する新しい集団通信「Reshard」をNVIDIA Technical Blogで発表しました。参照実装の「NCCL M2N Reshard」はオープンソースとしてGitHubのnccl-extensionsリポジトリで公開されています。後学習フレームワークNeMo RLでの計測では、従来の方式と比べて2.7〜5.7倍の高速化を確認しています。
refitとは何か
RLの後学習では、現在のモデルで推論を走らせて学習用のデータをその場で生成します。効率を上げるため、推論と学習を別々のGPU群で並行して動かす構成が一般的です。モデルの更新は学習側のGPUで行われるため、推論側のGPUにも定期的に最新の重みを送り直す必要があります。この転送がrefitです。
refitには2つの難しさがあります。1つは、推論と学習で必要な計算の性質が違うため、データ並列やテンソル並列、エキスパート並列といった分割の仕方が両者で異なることです。もう1つは、すべての重みを更新するため、通信量がモデル全体の重みのサイズに匹敵することです。最新の巨大モデルでは、この通信量がすでに非常に大きくなっています。
1回あたり約10TBに達する通信量
従来のrefitは「gather-and-broadcast」と呼ばれる方式が主流です。学習側のGPUが手元の断片を集めてパラメーター全体を復元し、それを推論側のGPUへ丸ごと送り、推論側は自分に必要な部分だけを残します。仕組みは単純ですが、推論側は一部しか使わないのに全体を受け取るため、集める段階と配る段階の両方で無駄な通信が生じます。
| モデル | 重みのサイズ(BF16) | refit1回の通信量の推定 |
|---|---|---|
| Kimi K3(2.8兆パラメーター) | 約5.6TB | 約11.2TB |
| Qwen 3.8 2.4T A95B(2.4兆パラメーター) | 約4.8TB | 約9.6TB |
NVIDIAの試算では、現在最大級のオープンウェイトモデルでは、refit1回あたりの通信量が約10TBに達します。しかもこの処理は学習のステップごとに必要です。モデルが大きくなるほど負担は増えるため、通信量そのものを減らす方法が求められていました。
DTensorの再分割として捉え直す
NVIDIAは、refitで送るべきデータを理論上の最小量に絞るという考え方から出発しました。鍵になったのは、PyTorchの分散テンソル「DTensor」という既存の抽象化です。DTensorは、GPU間でテンソルをどう分割し、どう複製しているかを表現する仕組みで、refitは「学習側の配置から推論側の配置へDTensorを再分割する問題」として言い換えられます。
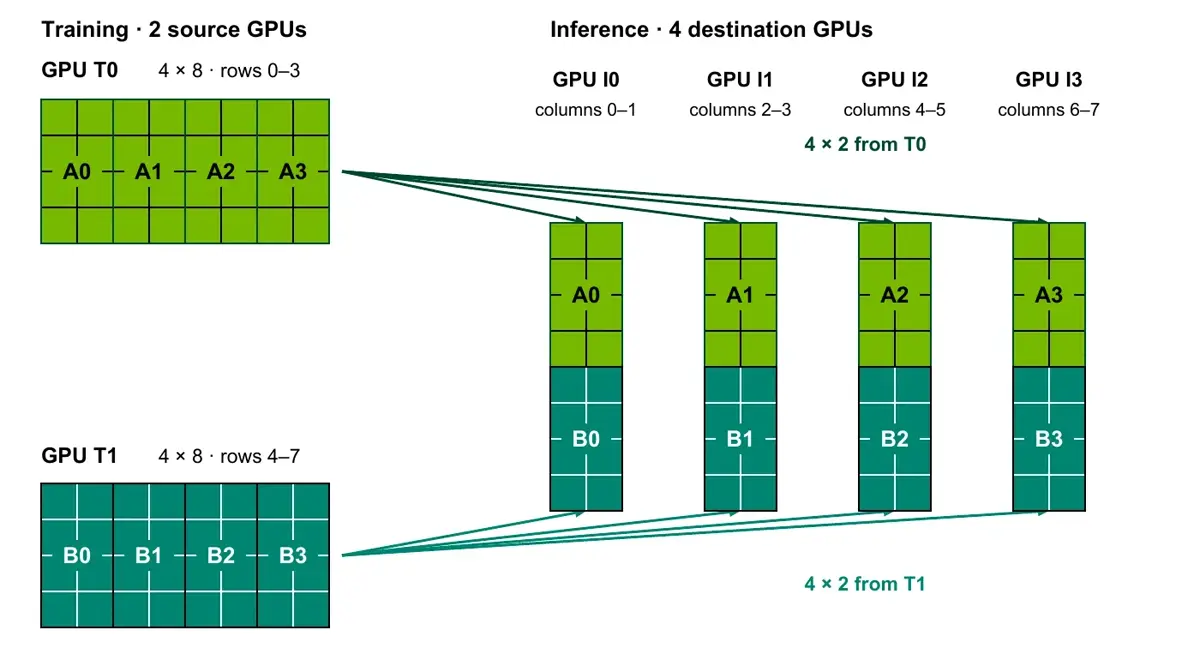
画像引用元: NVIDIA Technical Blog
たとえば8×8の行列を、学習側では2台のGPUで行方向に、推論側では4台のGPUで列方向に分けているとします。推論側の各GPUは、学習側の各GPUから4×2の領域を受け取るだけで、必要な8×2の断片をそろえられます。行列全体を復元する必要はありません。Reshardは、all-reduceやall-gatherと同じように1回の呼び出しで使える集団通信として、この転送を実装しています。
NVLinkを使って重複転送をなくす
NCCL M2N Reshardは、まず送り手と受け手の断片が重なる範囲を正確に割り出し、その転送をGPUの物理的な接続に割り当てます。同じ重みを複数の推論GPUが必要とする場合でも、ネットワーク越しには1回だけ送ります。受け取ったGPU同士は高速なNVLinkで残りの部分を交換し、それぞれが完全な断片を組み立てます。
ネットワーク転送とNVLink上の交換は並行して進むため、互いの待ち時間を隠せます。単純な直接転送では同じ断片を2回送るぶん帯域が半分になりますが、この方式なら各断片がネットワークの帯域をまるごと使えるとNVIDIAは説明しています。
計測では最大5.7倍の高速化
NeMo RLへの実装では、割り切った設計を採っています。最新のLLMでは、Transformerブロックのフィードフォワード層の重みがパラメーター全体の約95%を占めます。そこで、この大きな重みにはReshardを使い、QKV射影などの小さな重みには従来のgather-and-broadcastを残すハイブリッド方式にしました。
| システム | モデル | 従来方式 | Reshard |
|---|---|---|---|
| DGX H100 | Qwen 3 235B | 6.4秒 | 1.9秒 |
| DGX H100 | DeepSeek v3 671B | 14.9秒 | 2.6秒 |
| DGX GB200 | DeepSeek v3 671B | 6.1秒 | 2.3秒 |
| DGX GB200 | Nemotron Ultra v3 | 8.2秒 | 2.3秒 |
refitだけを測ったマイクロベンチマークでは、2.4兆パラメーターのQwen3.8 2.4T(BF16)でも転送は4.3秒で済みました。兆パラメーター級のモデルを想定した設計であることがわかります。
RLの後学習を回すチームへの影響
RLによる後学習は、推論と学習を何度も往復させる処理です。refitの時間が短くなれば、そのぶんGPUの待ち時間が減り、同じ計算資源でより多くの学習ステップを回せます。巨大なMoEモデルを自前で後学習しているチームにとっては、効きやすい改善です。
NeMo RLを使っている場合は、設定を変えるだけでReshardの経路を有効にできます。対応するバックエンドや配置、精度モードはNeMo RLのrefitガイドとNCCL Reshardの設定要件にまとまっています。なお、障害復旧時にGPUの構成が変わるケースには現在は通信グループの作り直しで対応しており、NCCLのshrink/grow APIを使う方式は今後の更新で予定されています。

Accelerating Reinforcement Learning Weight Refit with the Reshard Collective
During reinforcement learning (RL) post-training, training trajectories are generated on the fly by running inference with the current policy model. For training efficiency, it is common to run…



