0:00 0:00
記事
NVIDIA Snapshot公開、LLM推論の起動を最大36倍高速化——GPUの状態ごと保存し、Kubernetes上で数十秒で復元
NVIDIAがKubernetes上のGPUワークロード向けチェックポイント・リストアシステム「NVIDIA Snapshot」をオープンソースで公開しました。初期化済みのCPU・GPUメモリを丸ごと保存して復元し、数分かかっていたLLM推論のコールドスタートを3.6〜42.7秒に短縮します。
NVIDIAは2026年11月10日、Kubernetes上で動くGPUワークロードのチェックポイントとリストアを行うシステム「NVIDIA Snapshot」を、オープンソースとして公開しました。初期化が終わった推論ワークロードのCPUメモリとGPUメモリを丸ごと保存し、別のPodで復元することで、LLMの推論レプリカを数分ではなく数秒から数十秒で立ち上げられます。
Snapshotは、NVIDIAのAIデータセンター向け基盤「NVIDIA DSX AI Factory Platform」を構成する新しいコンポーネントです。もともとは推論フレームワークNVIDIA Dynamoのワーカー向けに開発されたもので、ほかの推論エンジンやスケジューラー、コントローラーからも組み込めるようになっています。
LLMのコールドスタートが数分かかる理由
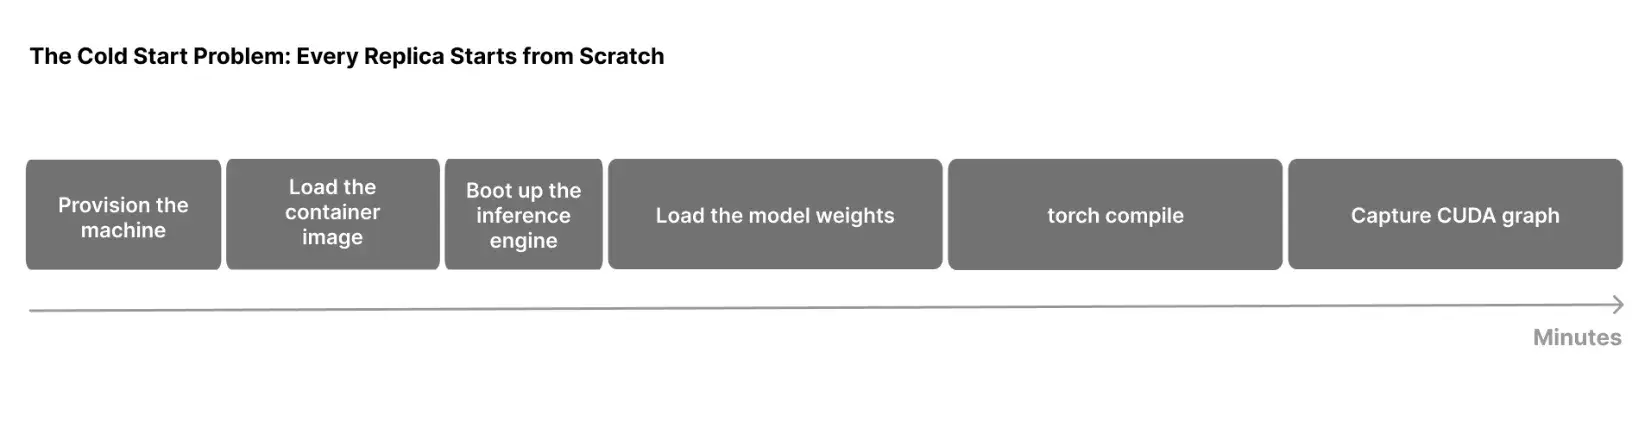
推論の需要が急に増えたときや、レプリカが落ちたとき、空いているGPUがあってもすぐにはサービスの処理能力になりません。LLMのワークロードを最初から起動する「コールドスタート」には、数分かかることがあるためです。
コールドスタートでは、マシンの準備とコンテナイメージの読み込みのあと、推論エンジンの起動、モデルの重みのGPUメモリへの読み込み、torch.compileによるコンパイル、CUDAグラフの取得といった処理が順番に走ります。重みの読み込みだけでなく、カーネルのコンパイルや自動チューニングにも長い時間がかかるのが実情です。
 画像引用元: NVIDIA Technical Blog
チェックポイントとリストアの2つの操作
Snapshotが提供する操作は2つです。1つはチェックポイントで、初期化が終わったワークロードのCPUとGPUのメモリを、持ち運びできる成果物として保存します。もう1つはリストアで、同じGPUモデルとドライバーを積んだノードであれば、その成果物から新しいPodを起動できます。処理は保存した時点から再開されるため、重みの読み込みやコンパイル、グラフの取得はすべて省略されます。
操作はどちらもKubernetesのカスタムリソースで行います。動いているPodを保存するならPodSnapshotを、テンプレートから起動して準備ができたらすぐ保存したいならSnapshotJobを作成します。復元は、新しいPodにnvidia.com/restore-fromアノテーションを付けてPodSnapshotを指定するだけです。ワークロード側には、保存前に一時停止し、復元後に再開するための小さな処理を入れる必要があります。
3つの推論エンジンで最大36倍の高速化
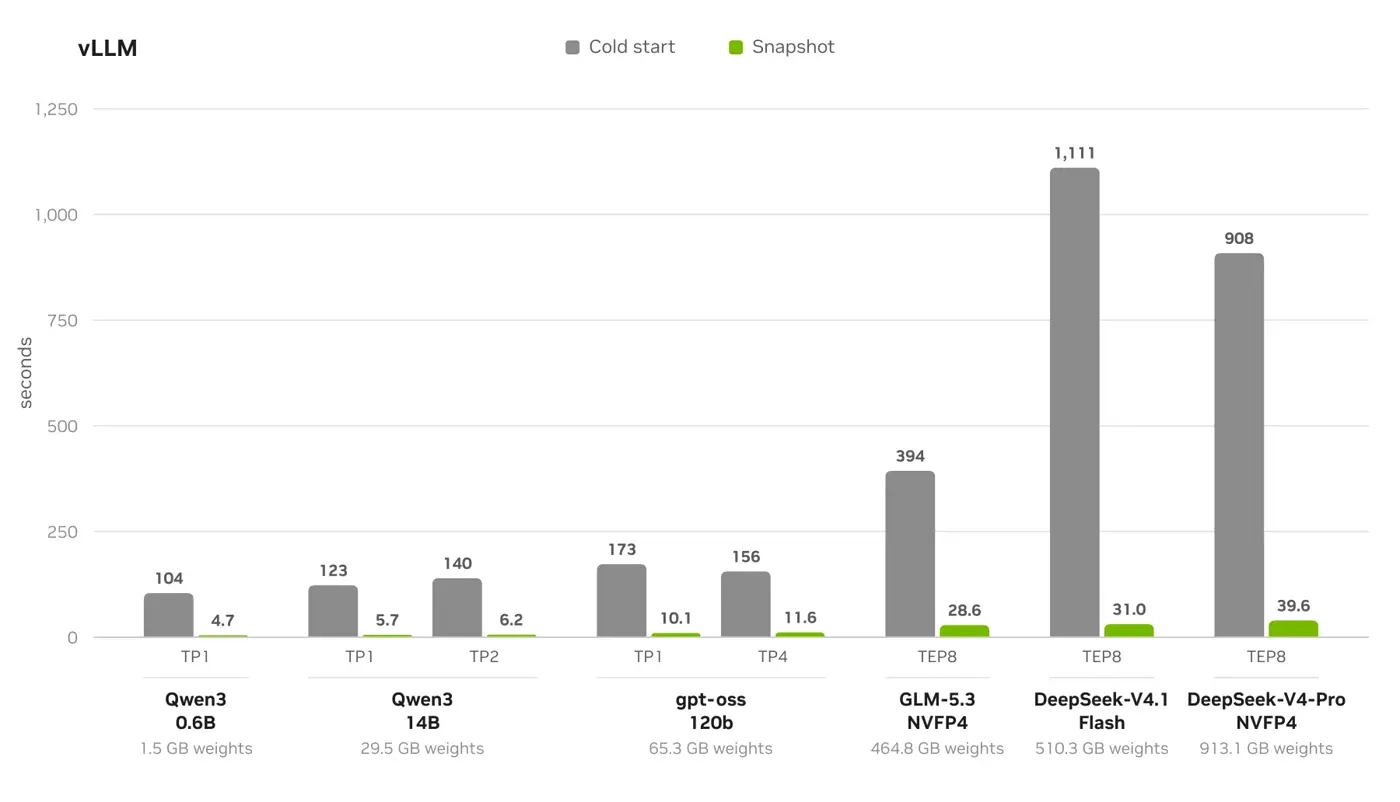
NVIDIAはvLLM、SGLang、TensorRT LLMの3つの推論エンジンで性能を測定しています。環境はNVIDIA B200 GPUとVASTのNFSストレージで、6億パラメータのモデルから、8基のGPUにまたがる約1TBのチェックポイントを持つMoEモデルまでを対象にしています。主な結果は次のとおりです。
| モデル | エンジン | コールドスタート | Snapshotで復元 | 高速化 |
|---|---|---|---|---|
| Qwen3-0.6B | SGLang | 87.08秒 | 3.59秒 | 24.26倍 |
| gpt-oss-120b(1GPU) | TensorRT LLM | 200.55秒 | 7.79秒 | 25.75倍 |
| GLM-5.3-NVFP4(8GPU) | vLLM | 393.65秒 | 28.64秒 | 13.74倍 |
| DeepSeek-V4.1-Flash(8GPU) | vLLM | 1110.65秒 | 30.96秒 | 35.87倍 |
全構成で復元時間は3.6〜42.7秒に収まり、コールドスタートより8〜36倍速くなりました。チェックポイントの作成には15秒から5.5分かかりますが、どの構成でも作成と復元の合計がコールドスタート1回分より短く、最初のレプリカを復元した時点で元が取れる計算です。
復元時間の内訳とパートナーの評価
8GPU構成の大規模MoEモデルでは、復元時間の大半をGPUの状態をメモリに戻す処理が占め、18〜29秒かかりました。Linuxのプロセス保存ツールCRIUによるCPUプロセスの復元は4.2〜10.8秒です。CPU側の速度は主にストレージの性能で決まるとされています。なお、測定はいずれもコンテナイメージの取得やランタイムの準備を含んでいません。
 画像引用元: NVIDIA Technical Blog
デザインパートナーによる評価も紹介されています。上流の開発にも参加しているCrusoeは、NVIDIA HGX B300でGLM-5.3のPodの準備完了までの時間を約8分から31秒に短縮しました。Saturn Cloudは、ゼロからスケールさせる推論でvLLMの起動を2〜8.5分から6〜34秒に縮めたとしています。
推論基盤を運用するチームへの影響
1台のノード内で複数GPUにまたがるワークロードも、ランクをまとめて1つのチェックポイントとして扱えます。テンソル並列やデータ・エキスパート並列、デコード時のコンテキスト並列といった構成のMoEモデルにも対応しており、リポジトリにはvLLM、SGLang、TensorRT LLM向けの設定例が用意されています。
GPUの台数を需要に合わせて増減させている推論基盤では、起動の遅さを見込んで余分なレプリカを常に動かしておくケースが少なくありません。数十秒で戻せるなら、その待機分を減らしたり、障害時の復旧目標を見直したりする余地が出てきます。まずは自社のモデルと構成で、チェックポイントの容量と復元時間がどの程度になるのかをリポジトリのベンチマークツールで測ってみるのがよさそうです。

Start and Restore GPU Workloads in Seconds with NVIDIA Snapshot
NVIDIA Snapshot, a new open-source component of the NVIDIA DSX AI Factory Platform, makes initialized GPU workloads reusable across inference replicas—speeding startup and recovery.