0:00 0:00
記事
NVIDIA TensorRT Edge-LLM、数コマンドでDGX Spark上にLLMを起動——投機的デコードで生成速度は最大1.7倍
NVIDIAが、組み込み向け推論ランタイム「TensorRT Edge-LLM」のtrtedge CLIを使い、DGX Spark 64GBでNemotron-3.5 Lightningを数コマンドで動かす手順を公開しました。OpenAI互換APIでの提供や、DSpark投機的デコードによる高速化の実測値も示しています。
NVIDIAは、組み込み機器向けのAI開発を手軽に始められるよう、TensorRT Edge-LLMとDGX Spark 64GBを組み合わせた手順を公開しました。付属のコマンドラインツール「trtedge」を使えば、モデルのダウンロードから最適化済みTensorRTエンジンのビルド、チャットの開始までを数コマンドで済ませられます。チュートリアルではNVIDIA Nemotron-3.5 Lightningを題材に、ローカルAPIサーバーの立ち上げや投機的デコードによる高速化まで解説しています。
エッジAI開発の「準備の手間」を減らす
AIの活躍の場はデータセンターの外へ広がっています。ドライバーの注意力や車内環境の監視、ロボットによる周囲の把握と作業計画、製造ラインでの機械群の協調など、いわゆるフィジカルAIのアプリケーションは、限られたメモリ、電力、レイテンシーの中で認識・推論・行動をこなさなければなりません。一方で、モデルを実機で動かせる状態にするまでには相当な準備が必要になるのが実情でした。
NVIDIAは、新たに64GB構成が加わったDGX Sparkを、組み込み開発者がモデルやエージェントを試作・微調整・検証するためのプラットフォームと位置づけています。そこにTensorRT Edge-LLMを組み合わせることで、開発環境と本番環境の間のギャップを小さくする狙いです。
開発から実機展開まで同じランタイム
TensorRT Edge-LLMは、組み込みワークロード向けに設計された軽量なC++推論ランタイムです。DGX Sparkでの開発と、Jetson Thor、DRIVE AGX Thor、IGX Thorといった展開先のプラットフォームで、同じ推論フレームワークを使えるのが特徴です。
必要な環境は、対応するソフトウェアスタックを入れたDGX Spark、CUDA 13、TensorRT 10.16.1.11以降(10.x系)、Python 3.10〜3.12です。仮想環境を作ってtensorrt-edgellm[server]をpipで入れたあと、trtedge chatにモデル名を渡すだけでチャットが始まります。初回は約21GBのモデルのダウンロードとエンジンのビルドが走りますが、2回目以降はキャッシュ済みのエンジンが再利用されます。
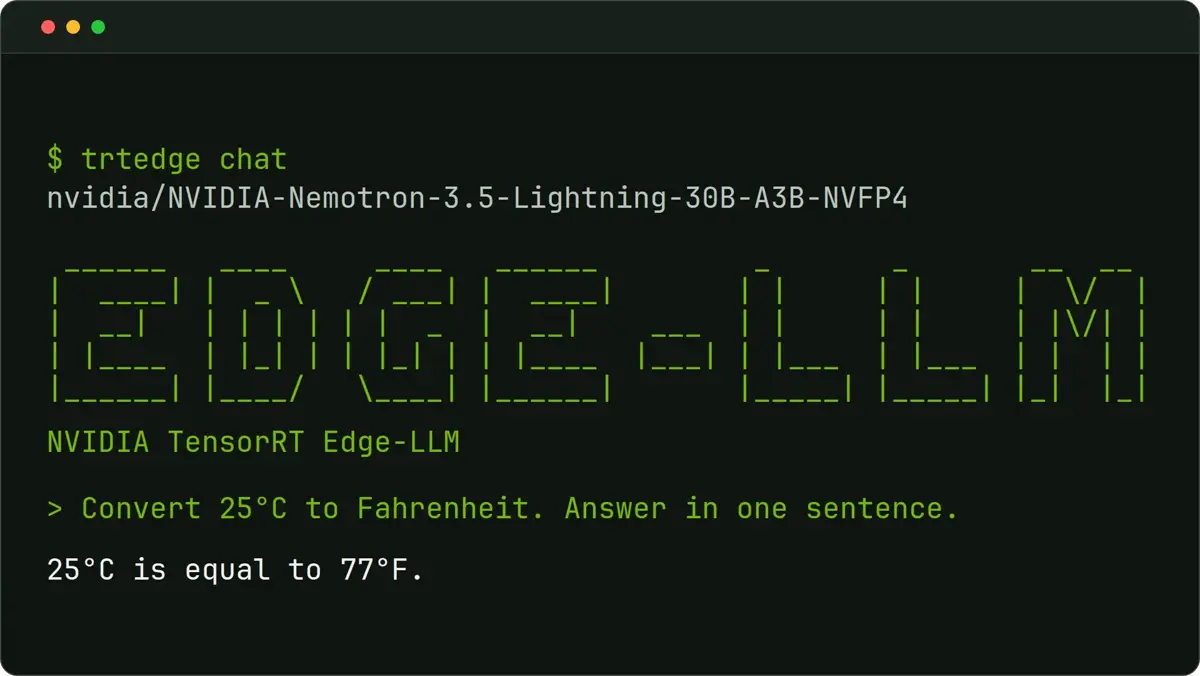
画像引用元: NVIDIA Technical Blog
OpenAI互換APIでアプリの試作にも対応
チャットで動作を確かめたら、trtedge serveコマンドでモデルをローカルのAPIサーバーとして公開できます。エンドポイントはOpenAI互換の/v1/chat/completionsで、ストリーミング応答にも対応しています。既存のOpenAI向けクライアントやツールをそのまま向け先だけ切り替えて使えるため、アプリケーションの試作や検証がしやすくなります。
起動状態は/health/readyエンドポイントで確認でき、"status":"ready"が返れば準備完了です。サーバーは設定に応じてエンジンをビルドするか、既存のものを再利用します。ローカルで完結するため、試作段階で外部APIの利用料や通信遅延を気にせずに済むのも利点です。
DSpark投機的デコードの実測値
生成をさらに速くしたい場合は、DSpark投機的デコードを有効にできます。これはドラフトモデルが複数のトークンを先回りして提案し、メインモデルが1回のパスでまとめて検証する仕組みです。NVIDIAがドラフトトークン数を3に設定して計測した結果は次のとおりです。
| ワークロード | TTFT中央値(OFF→ON) | 平均生成速度(OFF→ON) |
|---|---|---|
| SpeedBench 1K | 201.0ms→203.0ms | 73.3→108.5トークン/秒 |
| SpeedBench 2K | 329.5ms→331.6ms | 72.8→105.3トークン/秒 |
| HumanEvalプロンプト | 98.1ms→98.7ms | 73.4→126.9トークン/秒 |
最初のトークンが出るまでの時間はほぼ変わらないまま、生成速度は1.4〜1.7倍程度に伸びています。DSpark有効時のピークメモリ使用量はOSを含めて27.9GBでした。計測はNVFP4、思考モード有効、バッチサイズ1、出力上限128トークンという条件で行われています。
組み込みAIの検証を机の上で始められる
Nemotron-3.5 Lightning以外にも、画像や動画を理解する視覚言語モデル、音声認識や音声合成のモデルなどがサポート対象に含まれています。モデルごとの手順や展開先プラットフォームでの要件は、TensorRT Edge-LLMのドキュメントにまとめられています。
ロボットや車載機器向けのAIを開発しているチームにとっては、実機のJetson ThorやDRIVE AGX Thorを用意する前に、手元のDGX Sparkで同じランタイムを使ってモデルの性能やプロンプト設計を詰められる点が大きいでしょう。まずはtrtedge CLIで手持ちのユースケースを試し、生成速度とメモリ使用量が実機の制約に収まるかを確かめるところから始めるのが現実的な進め方です。

Run AI Models for Edge Application Development with Just a Few Commands
AI is expanding beyond the data center as developers build a new generation of agents to act at the edge: monitoring driver attention and cabin conditions, helping robots understand their surroundings…



