0:00 0:00
記事
NVIDIA「Vera Rubin NVL72」がMLPerf Inference初参戦——GB300比最大3.7倍のスループットを記録
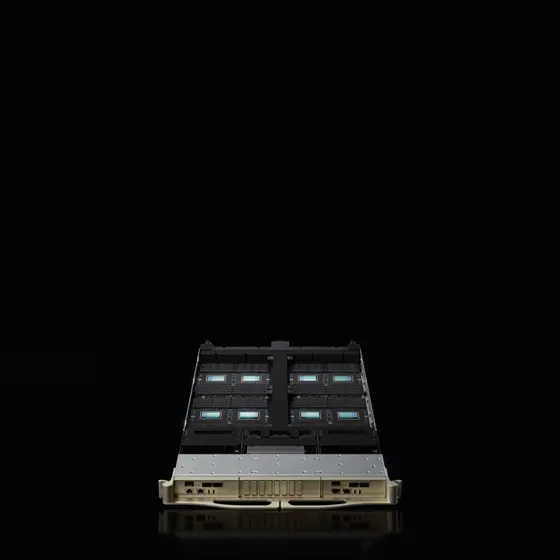
NVIDIA公式ブログによれば、MLPerf Inference v6.1でVera Rubin NVL72システムが初参戦し、GB300 NVL72比で最大3.7倍のスループットを達成しました。GB300 NVL72のスケーリング効率やソフトウェア最適化の成果もあわせて紹介します。
NVIDIAは公式ブログで、業界標準のAI性能ベンチマーク「MLPerf Inference v6.1」の結果を発表しました。今回の目玉は、次世代プラットフォーム「Vera Rubin NVL72」の初参戦です。プレビュー提出ながら、現行世代のGB300 NVL72を大きく上回るスループットを記録し、あわせてGB300 NVL72のスケーリング効率や継続的なソフトウェア最適化の成果も明らかになりました。
Vera Rubin NVL72、初参戦で最大3.7倍のスループット
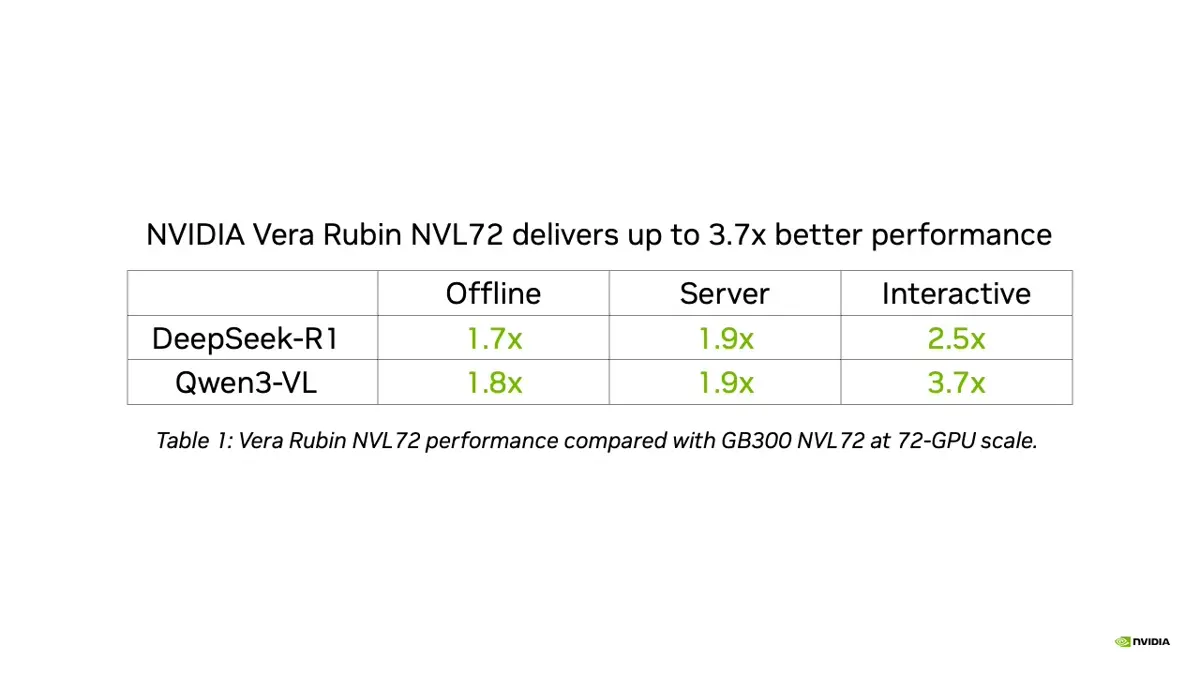
NVIDIAは、MLPerf Inference v6.1で最も負荷の高いベンチマークの2つであるDeepSeek-R1とQwen3-VLに、Vera Rubin NVL72のプレビュー結果を提出しました。Qwen3-VLではvLLMとDynamo推論フレームワークを組み合わせ、オフライン・サーバー・インタラクティブの各シナリオでGB300 NVL72比最大3.7倍のスループットを記録。DeepSeek-R1ではTensorRT-LLMライブラリを用い、最大2.5倍の性能を達成しました。NVFP4精度による省メモリ化やprefill/decodeの分離提供、大規模なエキスパート並列処理など、ハードウェアとソフトウェアを一体で設計した成果だとNVIDIAは説明しています。
GB300 NVL72は4ラック構成で99%のスケーリング効率
もう一つの焦点が、既存世代であるGB300 NVL72のスケーリング効率です。DeepSeek-R1のオフラインシナリオにおいて、1ラック(72GPU)から4ラック(288GPU)へと規模を拡大したところ、スループットはほぼ比例して伸び、99%のスケーリング効率を達成しました。GPUを増やしても性能が比例して伸びなければインフラ投資が無駄になるため、この結果はラックスケールの相互接続とソフトウェアが一体で機能していることを示しています。あわせてWAN 2.2のテキストから動画生成のベンチマークでも、単一ノード比で9倍のスループットと7.5倍低いレイテンシーを記録しました。
画像引用元: NVIDIA Blog
ソフトウェア最適化の継続的な積み上げ
NVIDIAはハードウェアの世代交代だけでなく、ソフトウェア面での継続的な改善も強調しています。v6.1では、KVキャッシュの低精度化やカーネル融合、vLLMとDynamoによる分離提供の強化などにより、GB300 NVL72のQwen3-VL性能がv6.0比で最大1.6倍に向上しました。さらに提出締め切り後もソフトウェア最適化は続いており、GPT-OSS-120BやDLRMv3では、MLCommonsによる検証はまだ済んでいないものの、追加の性能向上が確認されているといいます。
- Vera Rubin NVL72(プレビュー): Qwen3-VLで最大3.7倍、DeepSeek-R1で最大2.5倍のスループット(GB300 NVL72比)
- GB300 NVL72のスケーリング: 1→4ラック(72→288GPU)で99%の効率、ほぼ線形にスループットが向上
- ソフトウェア最適化: v6.0→v6.1でQwen3-VL性能が最大1.6倍に、提出後も追加の性能向上を確認
- エージェント向け指標: SemiAnalysis AgentXベンチマークでGB300 NVL72比30倍の性能(プレビュー)
エッジからパートナーエコシステムまで広がる検証
今回の提出はデータセンター向けだけにとどまりません。NVIDIAは新設された「Edge-Agentic」ベンチマークにおいて、Qwen3.6-27Bモデルを用いたJetson AGX ThorとTensorRT Edge-LLMの結果も提出しました。エコシステム全体でも、ASUS、Azure、Cisco、CoreWeave、Dell Technologies、HPE、Oracle Cloud Infrastructure、Supermicroなど19のパートナーが参加し、うち8社はマルチノードのBlackwell NVL72システムで良好な結果を示したとしています。エッジデバイスから大規模なAIファクトリーまで、幅広い規模で検証が進んでいる格好です。
AI推論の経済性は、単純な演算性能だけでなくスケーリング効率とソフトウェアの進化速度によって左右されます。Vera Rubin NVL72はまだプレビュー段階の結果ですが、今回の数値は次世代プラットフォームへの移行が性能面で大きな伸びしろを持つことを示しており、インフラ投資を検討する企業にとって重要な判断材料になりそうです。
NVIDIA Vera Rubin NVL72 Delivers Leading Performance in MLPerf Inference v6.1 Debut
First preview submission using NVIDIA Vera Rubin NVL72 systems delivers up to 3.7x better throughput than NVIDIA GB300 NVL72.