0:00 0:00
記事
NVIDIA Vera Rubin NVL72、MLPerf Training v6.1に初登場——7種目中6種目で最速、GB300比で最大2倍
NVIDIAは、MLPerf Training v6.1でVera Rubin NVL72が初めて結果を提出し、7種目中6種目で最短の学習時間を記録したと発表しました。DeepSeek-V3 671Bでは同じ1,024 GPU構成のGB300 NVL72に比べ、学習時間をほぼ半分に短縮しています。
NVIDIAは2026年11月16日、AI学習性能のベンチマーク「MLPerf Training」の最新ラウンドv6.1に、次世代プラットフォームVera Rubin NVL72が初めて結果を提出したと公式の技術ブログで発表しました。
Vera Rubin NVL72は初登場ながら、全7種目のうち6種目で最短の学習時間を記録し、GPUあたりの性能は最適化済みのGB300 NVL72と比べて最大2倍に達しました。残る1種目でも、10,240基のGB300 NVL72によるクラスタがラウンド全体の最速記録を出しており、NVIDIAのプラットフォームが全種目で首位を占めた形です。
同じGPU数で比べると1.4〜2倍
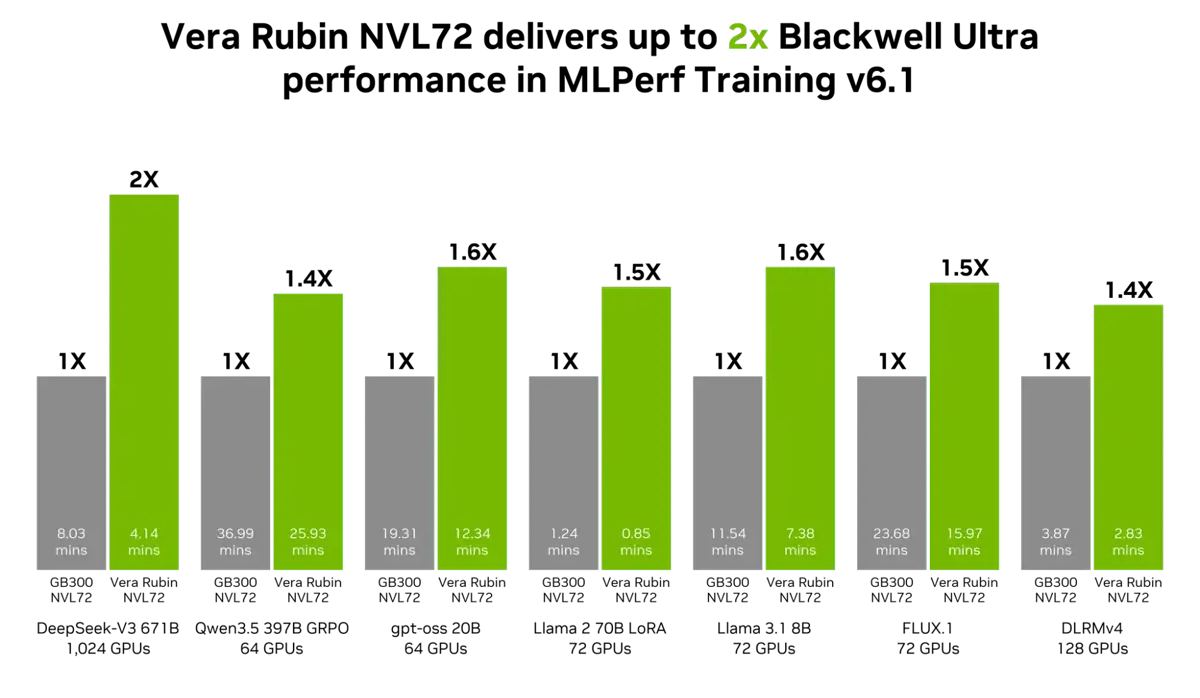
今回の結果は、同じGPU数のGB300 NVL72を基準に、Vera Rubin NVL72がGPUあたりどれだけ速いかを比べると分かりやすくなります。NVIDIAが公開した比較は次のとおりです。
| ベンチマーク | 種類 | GB300 NVL72比 |
|---|---|---|
| DeepSeek-V3 671B | MoEの事前学習 | 約2.0倍 |
| gpt-oss 20B | MoEの事前学習 | 約1.6倍 |
| Llama 3.1 8B | LLMの事前学習 | 約1.6倍 |
| Llama 2 70B LoRA | ファインチューニング | 約1.5倍 |
| FLUX.1 | 画像生成 | 約1.5倍 |
| Qwen3.5 397B GRPO | 強化学習による事後学習 | 約1.4倍 |
| DLRMv4 | レコメンデーション | 約1.4倍 |
 画像引用元: NVIDIA Technical Blog
NVIDIAは、モデルが大きく通信量の多いワークロードほど差が広がると説明しています。言語、画像生成、レコメンデーション、強化学習と分野をまたいで性能が伸びている点も強調しています。
DeepSeek-V3では学習時間がほぼ半分に
もっとも負荷が高いのは、6,710億パラメータのMixture-of-Experts(MoE)モデルであるDeepSeek-V3 671Bです。エキスパート並列で動くため、毎回のイテレーションでGPU同士の大量の全対全通信が発生し、ネットワークの効率がそのまま学習時間に表れます。
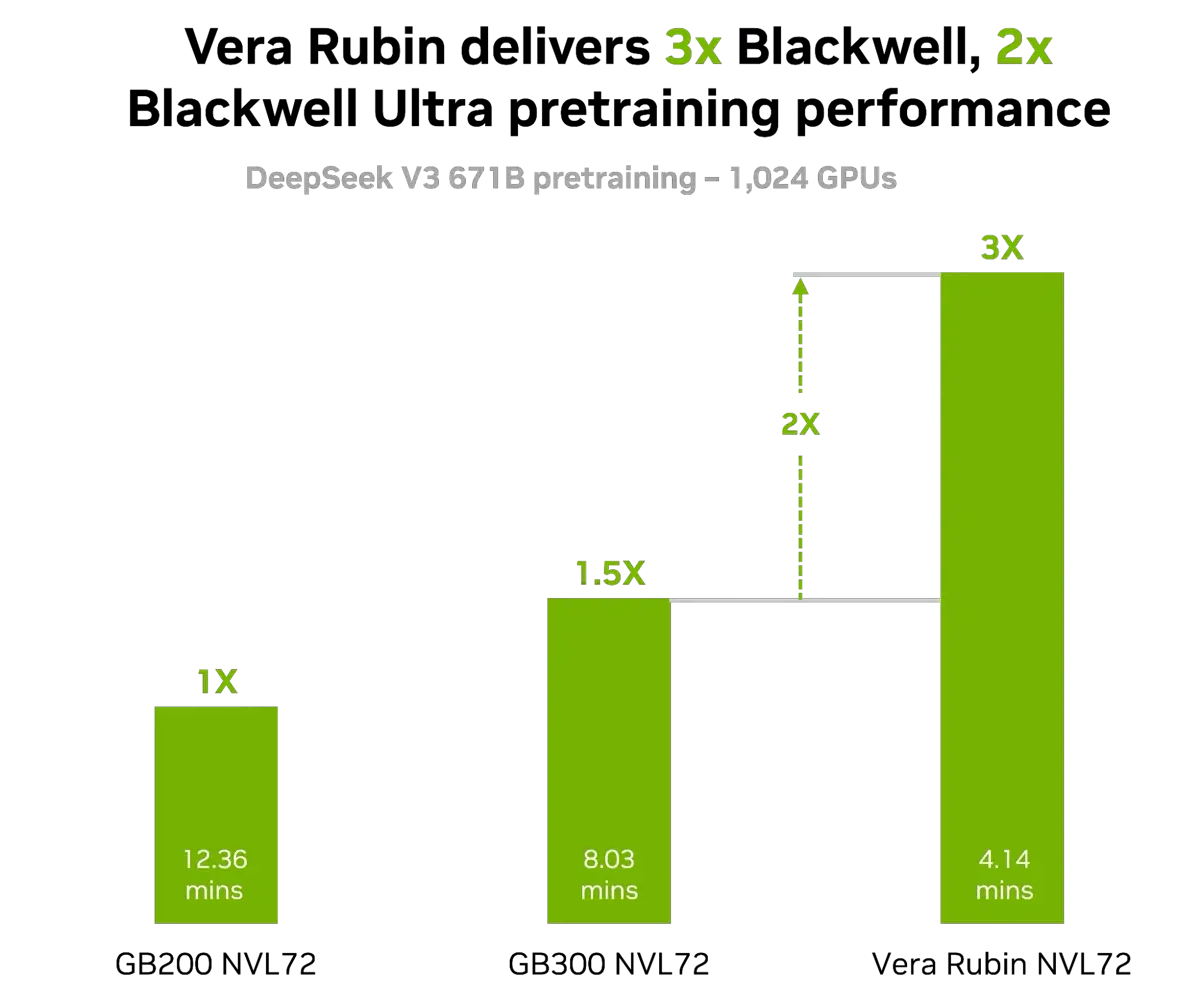
Vera Rubin NVL72は16ラック・1,024基のGPUでこのベンチマークを4.14分で完了しました。同じ1,024基構成のGB300 NVL72は8.03分だったため、GPUあたりでほぼ2倍の差が付いています。さらに前世代のGB200 NVL72は12.36分で、3世代を並べるとVera RubinはGB200の約3倍の速さになります。
 画像引用元: NVIDIA Technical Blog
NVIDIAは、学習時間が半分になれば四半期に回せる実験の数がおよそ倍になり、それがモデルの品質向上につながると述べています。なお、規模を優先した構成では、GB300 NVL72が160ラック・10,240基のGPUで1.38分というラウンド最速の記録を出しました。
新設の強化学習ベンチマークでも首位
v6.1では、エージェント型LLM向けの強化学習による事後学習を測る初めてのベンチマーク「Qwen3.5 397B GRPO」が追加されました。ロールアウトの生成、採点、重みの更新を繰り返すため、推論エンジンと学習エンジンの間で重みを頻繁に移す必要があり、システム全体に高い負荷がかかります。
Vera Rubin NVL72は1,024基で10.44分を記録し、同条件のGB300 NVL72(13.78分)を上回りました。推論バックエンドにはNVIDIA NeMo RLとTensorRT-LLMの組み合わせを使い、vLLM版でも10.94分で結果を提出しています。
ロールアウトのたびにツール呼び出しやコードの実行を模擬する環境を動かす必要があり、この部分はCPUの処理が中心です。NVIDIAによると、Vera CPUのラック1台で256基のCPUが22,500以上の強化学習環境を同時に動かし、GPUに途切れなくフィードバックを供給できるとしています。
NVLink 6と97%超のスケーリング効率
ラックの内部では、72基のGPUと36基のCPUを銅線のNVLink 6でつないでいます。帯域はGPUあたり3.6TB/s、ラックあたり260TB/sで、MoEのエキスパート間通信がボトルネックになりにくい設計です。ラックの外へはConnectX-9 SuperNICから、Quantum-X800 InfiniBandまたはSpectrum-X Ethernetで拡張します。
この構成により、DeepSeek-V3では4ラック・256基から16ラック・1,024基まで広げても、97%を超えるスケーリング効率を保ちました。NVL72という72GPU単位の構成は世代をまたいで共通しているため、運用の仕組みを変えずに性能だけを引き上げられる点もNVIDIAは強調しています。
ソフトウェア面では、提出後に新しいビルドで再測定したところ、Llama 3.1 8B、gpt-oss 20B、DLRMv4の学習時間がさらに短くなったとしています。ただし、これはMLCommonsの検証を経ていない参考値です。
AI基盤の調達計画に影響しそう
今回の提出のうち、クローズド部門の80%がNVIDIAのプラットフォームで動いており、20のパートナー企業が参加しました。Vera Rubin NVL72はすでに世界中のクラウドインフラパートナーを通じて一般提供されているとしています。
自社でLLMの事前学習や強化学習による事後学習を回しているチームにとっては、同じGPU数で学習時間が1.4〜2倍短くなるという数字は、調達やクラウドの予約を考えるうえでの判断材料になります。特にMoEモデルや強化学習の比重が高いワークロードほど恩恵が大きいため、来年度のGPU計画を見直す際には、自社のモデル構成に近いベンチマークの結果を確認しておくとよいでしょう。

NVIDIA Vera Rubin NVL72 Achieves up to 2x Blackwell Ultra Performance in MLPerf Training v6.1
As AI agents tackle increasingly complex workflows, reducing time-to-train is critical for rapidly iterating on both models and the agents they power. MLPerf Training v6.1 marks the debut of the…



