0:00 0:00
記事
Underdog、32MBの音声合成モデル「Woof」を公開——ブラウザだけで動くデモゲームも
米スタートアップのUnderdogが、容量31.7MB、パラメーター数3100万の音声合成モデル「Woof」を使ったブラウザゲームを公開したとTechCrunchが報じました。インターネット接続なしで多くの端末で動作し、モデルは誰でもダウンロードできるとしています。
TechCrunchは2026年11月6日、AIスタートアップのUnderdogが、新しい音声合成(TTS)モデル「Woof」を使ったブラウザゲームを公開したと報じました。Woofの容量は31.7MBで、Underdogはブラウザ上で動くほど小さいとアピールしています。大規模なモデルの開発競争が続くなか、スマートフォンやPCなどの端末上で動く小型モデルに力を入れる企業の1つです。
タイプライターに打った文字を読み上げるゲーム
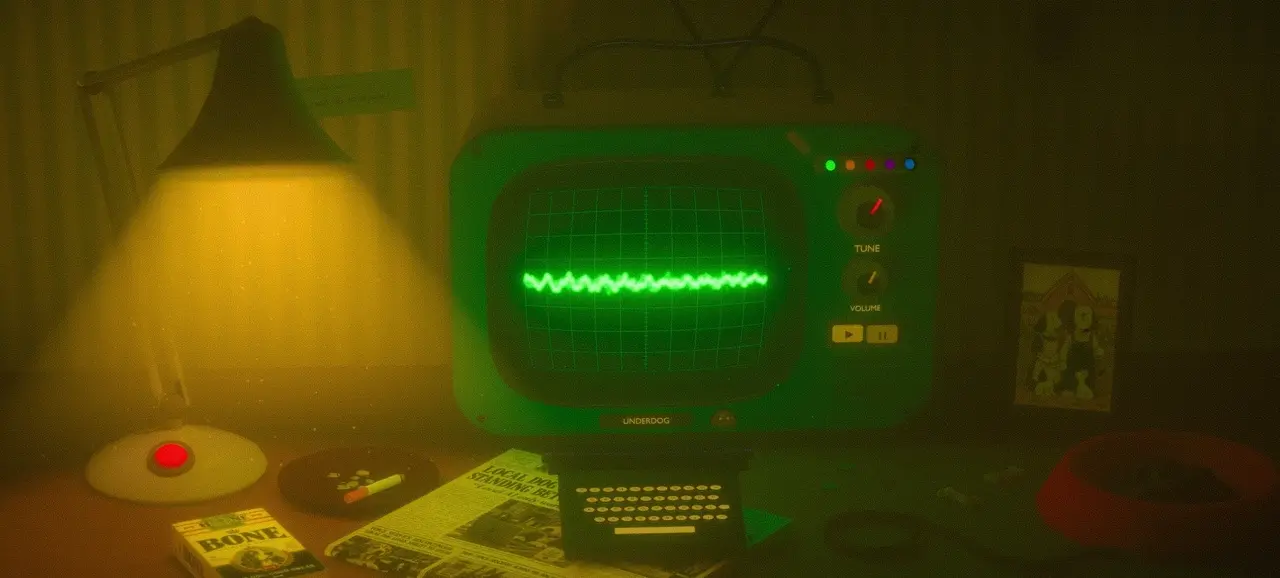
公開されたゲームの舞台は、タイプライターやブラウン管モニターが置かれたレトロな雰囲気の部屋です。デスクのランプはスイッチを押すと音が鳴り、冒頭では町にいる「押し付けがましい」クラウド事業者への注意が流れます。TechCrunchは、これをクラウド型のAIモデルへの皮肉と受け止めています。
プレイヤーはタイプライターと音楽のチューナーを操作できます。キーボードで好きな文章をタイプライターに打ち込むとゲームが読み上げ、チューナーを回すとさまざまな音楽が流れます。UnderdogはXへの投稿で、ゲーム内の声はすべてWoofによるものだと説明し、ボスキャラクターの「Darkcloud」を倒すと招待がもらえるとしています。
画像引用元: TechCrunch
3100万パラメーターでネット接続なしに動作
Underdogによると、Woofのパラメーター数は3100万で、ほとんどの端末でインターネットに接続せずに動作します。モデルは誰でもダウンロードできるオープンな形で公開されています。ゲームの音声も、ブラウザの中でWoofが生成したものです。
TechCrunchは、この規模のモデルが大型モデルに取って代わることはないだろうとしつつも、ローカルで動くアシスタントや、個人向けにポッドキャストを生成するといった用途には十分な可能性があると伝えています。音声をクラウドに送らずに済むため、通信環境に左右されにくく、入力した文章が外部に出ないという利点もあります。
ブラウザで動く小型AIモデルという流れ
ここ数年、AIモデルの開発は大規模化が目立ってきましたが、その反対側では、端末上で動かせる小さなモデルの開発も続いています。TechCrunchも記事の冒頭で、巨大なモデルには膨大な計算資源が必要になる一方、スマートフォンやPCなどのエッジデバイスで動く小型モデルを作る研究者やスタートアップがいると紹介しています。
小型モデルの利点は、クラウドの利用料や通信の遅延を気にせずに済むことと、データを手元に置いたまま処理できることです。Woofのように数十MBに収まれば、アプリやWebページに組み込んで配布するハードルも下がります。デモをゲームの形で公開したのも、ダウンロードやインストールなしにブラウザだけで動くことを手軽に体験してもらう狙いがあるとみられます。
UnderdogがこれまでにリリースしたAIモデル
Woofは、Underdogが進めている端末上で動くモデル群の1つです。TechCrunchの記事で触れられたものをまとめると、次のとおりです。
| モデル・製品 | 種類 | 特徴 |
|---|---|---|
| Woof | 音声合成 | 31.7MB、3100万パラメーター、ブラウザで動作 |
| Bark | 音声認識 | 167MB、文字起こしやディクテーション向け |
| 270億パラメーターのモデル | 言語モデル | ノートPCで動作 |
| ローカル実行型アプリ | アプリ | 待機リスト制、MuseやInstinctの代替をうたう |
音声認識モデルのBarkは、Woofの数週間前に公開されました。アプリについてUnderdogは、ユーザーの端末上で動く、MetaのMuseなどのAIエージェントの代替になると位置付けています。
創業者「今の高性能モデルは数カ月で手元の端末で動く」
創業者のSigil Wen氏はTechCrunchに対し、Granolaのような議事録ツールを使う代わりに、端末上で動くAIモデルで自分専用の仕組みを作りたかったことが開発のきっかけだと話しています。データをユーザー自身が持てるようにするのが狙いです。
Wen氏は「今の高性能なモデルの大半は、数カ月以内に、すでに持っている端末で動かせるようになると思う。私たちは、米国製でオープン、かつ高性能で、プライベートなAIを実現できる最良のオープンモデルを作りたい」と述べました。同社はこうした考えをマニフェストとしても公開しています。
開発者が小型音声モデルを試す意味
31.7MBという容量は、Webアプリに組み込んでも初回の読み込みで大きな負担になりにくい水準です。サーバー側でTTSのAPIを呼ぶ構成と比べると、利用量に応じた課金や通信の遅延を気にせずに済みます。読み上げ機能付きのWebサービスやゲーム、オフラインで使う業務アプリを作っている開発者にとっては、選択肢の1つになりそうです。
ただし今回の情報はUnderdog自身の説明とデモにもとづくもので、音質や日本語への対応状況は明らかになっていません。実際の導入を考える場合は、ブラウザのデモで聞き比べたうえで、対応言語やライセンスの条件を確認しておくと安心です。

Underdog shows off a 32MB speech model in new demo
Despite its small size, Underdog's new model can generate both speech and music.



