0:00 0:00
記事
GitHub「ReviewBench」公開——103.9M件のPRから作ったAIコードレビュー評価基盤
GitHubが、AIコードレビューエージェントを評価するための新ベンチマーク「ReviewBench」を公開しました。103.9M件のPRを分析した代表性の高いコーパスと、96.6%の人間合意率を持つ正解データで、レビュー精度を客観的に比較できます。
GitHubは、AIによるコードレビューエージェントを客観的に評価するための新しいオープンベンチマーク「ReviewBench」を公開しました。GitHub Copilotのコードレビュー機能(CCR)の品質改善に実際に使われてきた評価基盤を外部にも開放したもので、103.9M件のGitHub上のPull Requestを分析して作られた代表性の高いコーパスと、人間レビュアー・複数のフロンティアLLM・静的解析ツールを組み合わせた多面的な正解データが特徴です。研究者や開発者は自分のレビューエージェントを同じ基準で評価し、公開リーダーボードに結果を提出できます。
コードレビューエージェントの「強み」を測る物差しがなかった
エージェントによるコードレビューは、開発フローに欠かせない存在になりつつあります。しかし、レビュアーごとに指摘の多さ・ノイズの少なさ・重大な問題を見抜く精度にはばらつきがあり、どのツールが自分のワークフローに合うのかを客観的に比較する手段がこれまで乏しいという課題がありました。既存のベンチマークは、ラベル品質・カバレッジ・実際のレビューをどれだけ代表しているかのあいだでトレードオフを抱えており、厳密で再現性のある評価手法が存在する領域には大きな空白がありました。ReviewBenchはこの空白を埋めるために設計されています。
103.9M件のPRから設計した代表性の高いコーパス
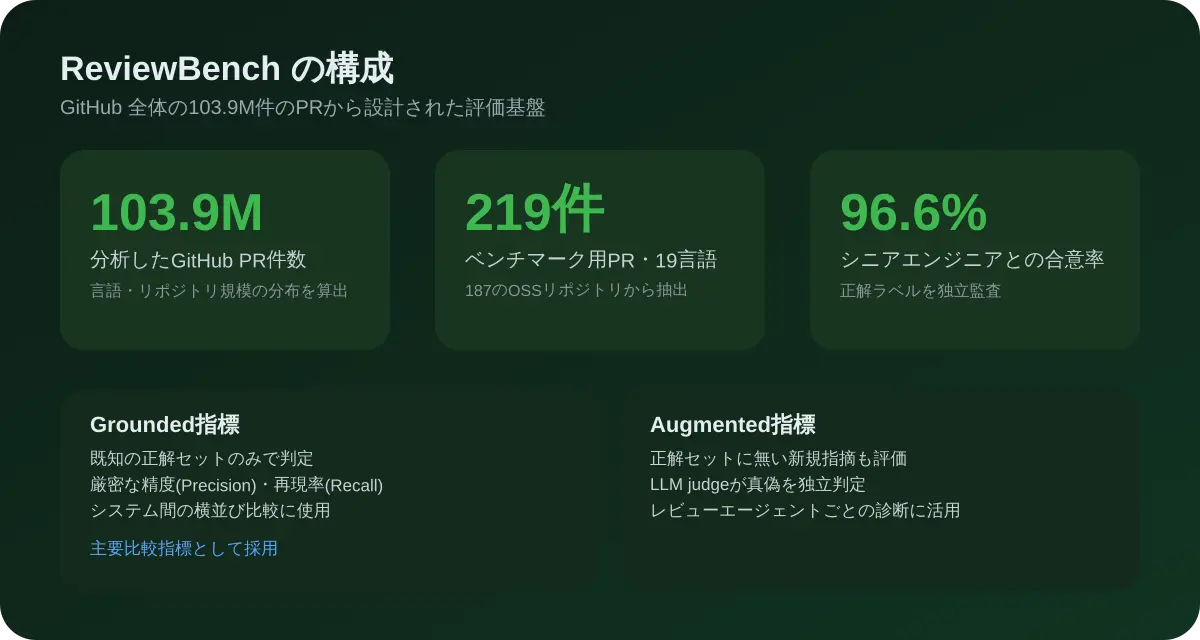
ReviewBenchは、GitHub上の103.9M件のPull Requestを分析し、言語・リポジトリ規模・変更の形から実際のレビュー作業の分布を把握したうえで構築されています。ベンチマーク本体は19言語、187の公開OSSリポジトリにまたがる219件のPRで構成され、GitHub全体の分布にほぼ沿う形に調整されています。唯一意図的に調整している点として、単一ファイルの小さな変更に偏りすぎないよう、レビューの質が問われる中規模からやや大きめのPRをやや手厚く含めています。正解データは人間レビュアー・複数のフロンティアLLM・静的解析ツールという複数ソースから候補を集め、重複を意味的に統合したうえで、共通のルーブリックのもとでClaudeのClaude Sonnet 5をジャッジとして採用し、真に妥当な指摘かどうかを検証しています。
GroundedとAugmented、2系統の評価指標で精度を測る
ReviewBenchは精度・再現率・F1スコアを2系統、合計6つの指標として報告します。「Grounded」指標は既知の正解データのみを対象にした厳密な比較で、エージェント間を横並びで比較する際の基準として使われます。一方「Augmented」指標は、正解データに含まれていない新しい指摘もLLMジャッジが独立に真偽を判定し、評価対象に加えます。レビューエージェントが年々賢くなるにつれて、固定された正解データだけでは捉えきれない有効な指摘が増えていくため、Augmented指標はそうした指摘を正しく評価するための仕組みです。加えて、重大度・カテゴリ別の絞り込みや、再現率と精度のどちらを重視するかを示すFβスコアの重み調整にも対応しており、利用者ごとに異なるレビューの好みに合わせて結果を並べ替えられます。
自社のCopilotコードレビューで実証——予測と本番結果が一致
GitHubはReviewBenchを使い、自社のCopilotコードレビュー(CCR)の継続的な改善に役立ててきたと説明しています。たとえば、複数のモデルの実行結果を1つのレビューに統合する「マルチモデルアンサンブル」をLiteティアに導入した際には、ReviewBench上で精度・再現率・コメント量の向上とレビューあたりコストの低下が予測されました。実際に本番のA/Bテストでも、精度に相当する指標(Addressed rate)が8.0%上昇、再現率に相当する指標が13.6%上昇、コメント量が61%増加し、レビューあたりコストは8.0%低下するという結果になり、オフラインの予測と同じ方向に動いたとしています。重大度別の評価でも、ReviewBenchは重大なコメントが227%増えると予測し、本番では262%増加という近い結果が確認されました。
誰でも自分のエージェントを評価・提出できる
ReviewBenchは研究プレビュー版として、ReviewBenchの公式サイトから利用できます。GitHubアカウントでサインインし、コンテナイメージと自前のモデルキーを使って自分のレビューエージェントを登録すれば、まず25件のPRからなるテストセットで調整し、準備ができたら219件全体を3ラウンド実行して、他の提出と同じジャッジでスコアリングされます。スコアはメンテナーのレビューを経て、既存のリーダーボードスコアを上回った場合、またはそのエージェントの初回提出の場合にのみ公開される仕組みです。PRデータセット・評価ルーブリック・ジャッジのモデル設定もすべて公開されており、自分のレビューエージェントの強みと弱みを具体的に把握できるようになっています。
ReviewBench: An open benchmark for AI code review
ReviewBench is a benchmark for code review agents built on representative GitHub pull requests, multi-source ground truth, and calibrated evaluation.