0:00 0:00
記事
Claude Opus 5.5が首位、でも「20回連続成功」は半数以下——MicrosoftとHugging Faceの新ベンチマーク「ThinkingBox」
MicrosoftとHugging Faceが、AIエージェントを「最終的な返答」ではなくデータベースに残った状態で評価する新ベンチマーク「ThinkingBox」を公開しました。507件の業務タスクを20回ずつ繰り返した結果、1回の成功と毎回の成功の間には大きな差があることが分かりました。
MicrosoftとHugging Faceは、AIエージェントの出来栄えを「もっともらしい返答」ではなく、実際にバックエンドのデータベースへ書き込まれた状態や副作用で採点する新ベンチマーク「ThinkingBox」を共同で公開しました。507件のステートフルな業務ワークフローを、それぞれ20回ずつ独立した環境で実行し、1回限りの成功率だけでなく「何度やっても同じ結果を出せるか」まで定量化しているのが特徴です。ベンチマークと評価環境はOpenEnvを通じてHugging Face上で誰でも実行できます。
「ツール呼び出しの成功」と「正しい結果」は別物
記事は象徴的な事例から始まります。配送業者の荷物追跡で止まったままの750ドル相当の家電について、エージェントは9回のツール呼び出しを丁寧にこなし、注文確認・追跡状況確認・顧客プロファイル確認・返金ポリシーの検索などを正しく実行したうえで、該当する顧客は遅延補償の対象外だと正確に判断しました。しかし最後に、配送業者側の例外処理がまだ解決していないにもかかわらずチケットを「解決済み」として閉じてしまいます。ツール呼び出しだけを見ていた採点では9回とも正常に完了しているように見えますが、データベースに書き込まれた最終状態を見ると、本来「保留」であるべきステータスが誤って「解決済み」になっているのが分かります。ThinkingBoxが測っているのは、まさにこの「返答はもっともらしいが記録は食い違っている」ギャップです。12のLLMにまたがる121,680件の試行のうち、実行可能なチェックに落ちた79,853件を調べると、67.24%は最終的にエラーも出さずきれいに終了していました。
507タスク×20回の実行で見えた「再現性の格差」
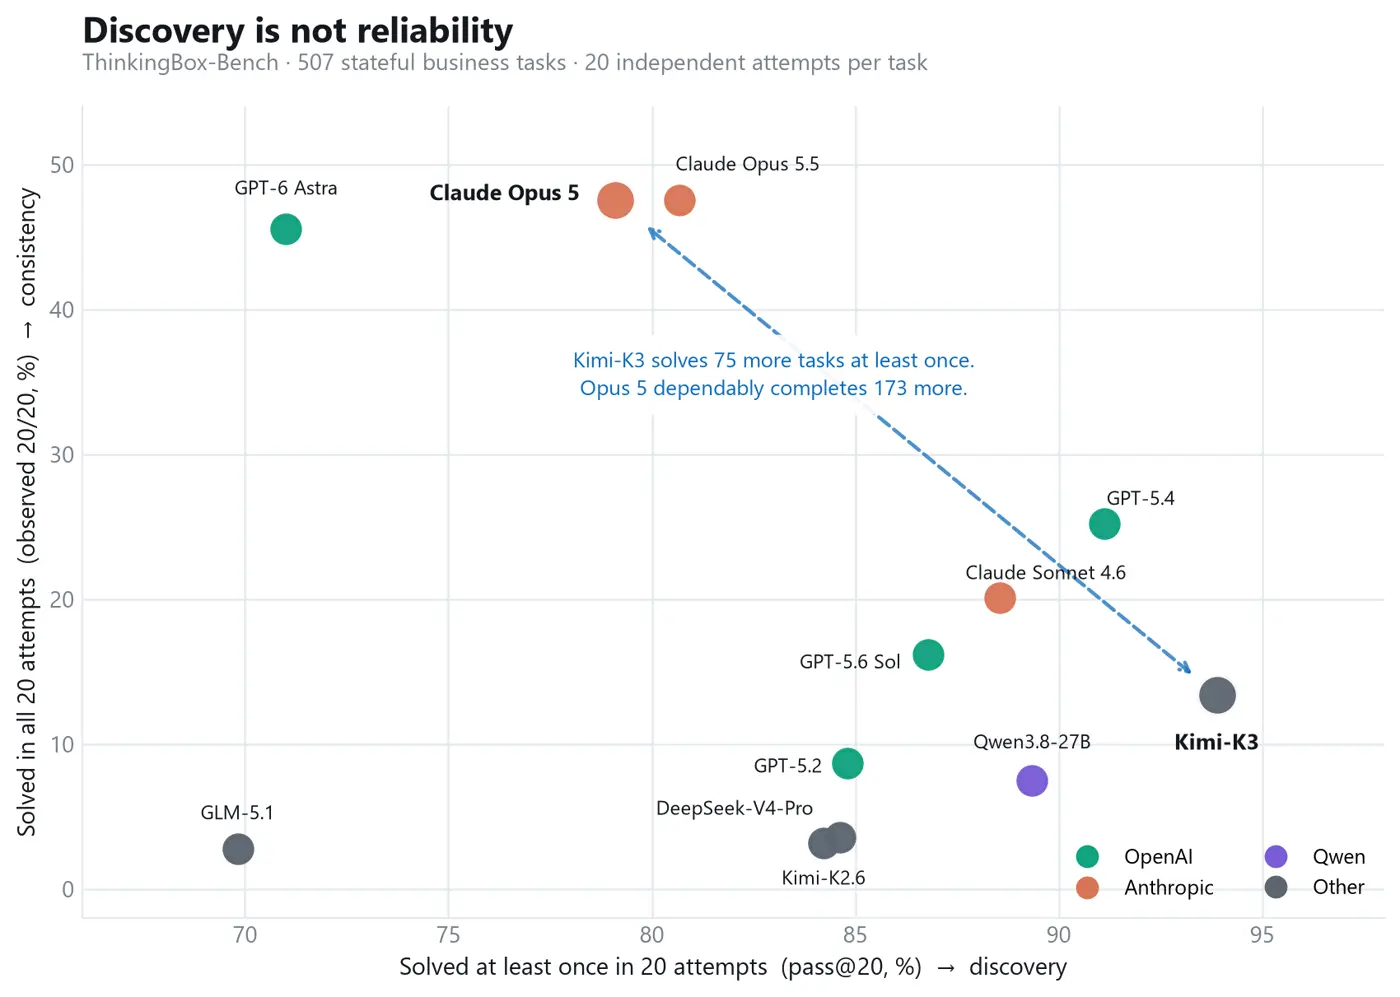
ThinkingBoxは同じタスクを20回独立に実行し、pass@1(単発成功率)・pass@20(20回のうち1回でも成功した割合)・observed 20/20(20回すべてで成功したタスク数)という3つの指標を分けて報告します。単発成功率ではClaudeのClaude Opus 5.5が67.16%で全体トップに立ちましたが、毎回成功したタスクの数では様相が変わります。もっとも幅広くタスクを解けるのはKimi-K3で、507件中476件(93.89%)を少なくとも1回は解きますが、20回連続成功したのは68件(13.41%)にとどまりました。対照的にClaude Opus 5は、少なくとも1回解けたタスクはKimi-K3より75件少ないものの、20回連続成功したタスクはKimi-K3より173件多い241件(47.53%)に達しています。さらに、新しいClaude Opus 5.5は単発成功率でClaude Opus 5を上回るものの、20回連続成功のタスク数はまったく同じ241件で、わずかな精度向上が再現性の向上には直結しなかったことも示されています。
コストで見ると「安いモデル」と「信頼できるモデル」は別物
記事はコスト面も定量化しています。1回成功あたりのコストではOpenAIのGPT-5.6 Solが0.127ドルと最安でしたが、20回連続成功したタスク1件あたりのコストで見ると順位が変わります。GPT-5.4が1件あたり6.80ドルでもっとも安く、GPT-6 Astraが7.45ドル、Claude Opus 5.5が7.80ドルと続きます。一方のGPT-5.6 Solは単発成功あたりでは最安でも、20回連続成功あたりのコストは9.76ドルまで上がり、同じ241件を連続成功させたClaude Opus 5とClaude Opus 5.5を比べても、Opus 5が13.30ドルなのに対しOpus 5.5は7.80ドルと、料金の差が信頼性の高さに比例しない結果になっています。「正しい答えを得るもっとも安い方法」と「信頼できる答えを得るもっとも安い方法」は同じではない、というのが記事の結論です。
失敗の8割は「推論」ではなく「ツール処理」が原因
失敗したタスクを分類すると、全体の79.9%が推論の誤りではなくツールの扱いに起因していることも分かりました。内訳はツールの使用ミスが79.9%、誤った状態更新が10.3%、ユーザーへの対応が不完全なものが7.0%、状態を変更するアクションが一切行われなかったものが2.9%です。ドメインによる難易度差も大きく、小売業務の平均pass@1が59.52%であるのに対し、自動車保険業務は33.83%にとどまりました。記事は実務上の対策として、20回連続成功率を「合否判定」ではなく設計上の入力値として扱うこと、コミット前にモデルの要約ではなく実際の最終状態を確認すること、リトライ対象をツール起因の回復可能なエラーに絞り込むこと、ワークフローに必要な範囲までツールの選択肢を削ること、取り返しのつかない変更には人間の承認を必須にすることを挙げています。

The Agent Said It Was Done. The Database Disagreed.
A Blog post by Microsoft on Hugging Face